<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://kocherovms.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://kocherovms.github.io/" rel="alternate" type="text/html" /><updated>2026-10-29T07:38:38+00:00</updated><id>https://kocherovms.github.io/feed.xml</id><title type="html">Заметки проекта neurolab</title><subtitle>Как устроен наш мозг</subtitle><author><name>Михаил Кочеров</name></author><entry><title type="html">137) охота за чемпионами</title><link href="https://kocherovms.github.io/2026/10/26/137.html" rel="alternate" type="text/html" title="137) охота за чемпионами" /><published>2026-10-26T10:35:00+00:00</published><updated>2026-10-26T10:35:00+00:00</updated><id>https://kocherovms.github.io/2026/10/26/137</id><content type="html" xml:base="https://kocherovms.github.io/2026/10/26/137.html"><![CDATA[<p>После 12 октября охота за чемпионами усилилась. После 25-ой и 26-ой линеек (которые были в конце сентября) никак не получалось натренить агентов, которые бы проходили дальше 5-го уровня. Упирались засранцы и всё.</p>
<ol>
  <li>была ставка, что нужно увеличить обзы. Ставка не сработала - заметка #136.</li>
  <li>дальше было подозрение, что новый <code class="language-plaintext highlighter-rouge">VisionHead</code> из <code class="language-plaintext highlighter-rouge">18d_world_model_09:183</code> какой-то бракованный. Однако, связка вижн хед <code class="language-plaintext highlighter-rouge">VisionHead:183</code> + <code class="language-plaintext highlighter-rouge">frostbite_07_old</code> дала результаты. Выходит, что дело было не в <code class="language-plaintext highlighter-rouge">VisionHead</code>, а в батч-нормализация внутри вижн хеда</li>
  <li>наличие батч нормализации внутри вижн хеда вместе с неявным багом в использовании этого вижн хеда на оптимизации даёт положительный результат - на 3-ем шаге рождаются носители полезного навыка “умеют проходить 5-ый уровень. Выходит, что на роллауте агент играет с одними статистиками, близкими к тем, которые были на обучении <code class="language-plaintext highlighter-rouge">WorldModel</code> (уровни вплоть до 10-го), а на оптимизации использует статистика батча. И вот это расхождение вносит какую-то регуляризационную составляющую, которая приводит к рождению агентов носителей</li>
  <li>захотелось избавиться от этого бага, т.к. это а) неконтролируемая хрень б) не позволяет масштабировать длину входной цепочки.</li>
  <li>почему-то подумалось, что дело в забывчивостм агента. Это частично подтердилось тем, что через <code class="language-plaintext highlighter-rouge">18n_explore_03</code> стало ясно, что агент на третьем шаге разучился играть на 5-ом азбучном уровне.</li>
  <li>сделал эксперимент с постепенным расширением адресного пространства <code class="language-plaintext highlighter-rouge">FFN</code> (<code class="language-plaintext highlighter-rouge">MLP</code>) в трансформере политики. Типа на первом шаге доступно 1/6 адресов для записи и чтения. На втором шаге доступно следующая 1/6 адресов для записи и 2/6 для чтения и т.д. Идея была в сохранении накопленного опыта. Но идея проавалилась, т.к. <code class="language-plaintext highlighter-rouge">FFN</code> (<code class="language-plaintext highlighter-rouge">MLP</code>) не живёт изолированно, а зависит от того, что в том числе проиходит в <code class="language-plaintext highlighter-rouge">Attention</code> слоях. Т.к. слои внимания мутируют, то ключи в <code class="language-plaintext highlighter-rouge">FFN</code> слое теряют синхронизацию с выходами слоёв внимания и модель разваливается.</li>
  <li>поэтому сделал шаг в сторону <code class="language-plaintext highlighter-rouge">LoRA</code> архитектуры (<code class="language-plaintext highlighter-rouge">frostbite_11</code>). Это когда модель морозится но на <code class="language-plaintext highlighter-rouge">MHA</code> и <code class="language-plaintext highlighter-rouge">FFN</code> слои сверху нашлёпываются низкоранговые прослойки, которые впитывают новый опыт. Но в запуск это дело не пошло, т.к. стало понятно, что пока получение носителей на третьем шаге решено не будет <code class="language-plaintext highlighter-rouge">LoRA</code> будет преждевременным</li>
  <li>поэтому натренил новый вижн хед без батч-норма (<code class="language-plaintext highlighter-rouge">VisionHead:294</code>). Вместо батч-норма взял <code class="language-plaintext highlighter-rouge">PixelNorm</code>. 45-ая линейка исследований показала, что туго, но носители рождаются и можно дальше тренить</li>
  <li>потом подумалось, что можно взять под контроль батч-норм, если перенести его напрямую в энкодер. Идея сначала обломалась (46-линейка), так как была неправильная реализация энкодера (флаг <code class="language-plaintext highlighter-rouge">is_ob_features_batch_norm</code> не пробрасывался). Со второго раза получили новый энкодер (<code class="language-plaintext highlighter-rouge">18d_world_model_10:29</code>). Но выяснилось, что и для него нужен хак в виде постоянного передёргивания на параметры того, какой был в <code class="language-plaintext highlighter-rouge">WorldModel</code> - флаг <code class="language-plaintext highlighter-rouge">is_world_model_ob_features_batch_norm</code>.</li>
  <li>к 26 октября пришли с пониманием, что надо просто брать вижн хед без батч-норма, энкодер без батч-норма, убирать все эти долбанные хаки и просто за счёт чуть большего кол-ва ранов на 3-ем шаге получать носителей. Также на 5+ шагах даёт эффект расширения окна обзов (<code class="language-plaintext highlighter-rouge">sequence_ages</code>)</li>
  <li>ещё стало понятно после прочтения <code class="language-plaintext highlighter-rouge">[DohareContLearn]</code>, что есть серьёзная проблематика с continual learning. На каждом шаге модель забывает старый опыт, и при этом плохо впитывает новый опыт. Именно поэтому азбука 5-го уровня на 3-ем шаге выветривается. Единственное, что спасает - это <code class="language-plaintext highlighter-rouge">nine_lives</code> в диете. Этот патч обеспечивает наличие в батчах оптимизации траекторий из всего спектра уровней. Поэтому агент как-бы умудряется сохранять опыть через этот костыль.</li>
</ol>

<p>Идеи, куда двигаться дальше зависят от целей. А цели, напоминаю, следующие:</p>
<ol>
  <li>убер-цель: разработать агента, который может уметь играть в широкий спектр игр</li>
  <li>под-цель: отточить необходимы для убер-цели механизмы на базе Frostbite. А для этого заставить его пройти дальше 10+ уровней.</li>
  <li>что это за механизмы: а) сохранение старого опыта (политика работы с памятью), б) пластичность и адаптивность к новому, в) иерархическое мышление агента (от целей высшего порядка, к моторике)</li>
</ol>

<p>Идеи, куда двигаться дальше:</p>
<ol>
  <li>подправить селектор <code class="language-plaintext highlighter-rouge">decisive_metric</code>. Сейчас он слеп к тем, кто на роллауте показывает большой потенциал. В итоге потомки рождаются не от тех, кто на 3-ем шаге научился проходить 5 уровней, а тот кто играет ровно, но имеет потолок. Короче, ведёт к стагнации. Надо, чтобы можно было явно выбирать более потециальных агентов</li>
  <li>в том или ином виде реализация идей из <code class="language-plaintext highlighter-rouge">[DohareContLearn]</code>. Например, частичная реинициализация сети (через расчёт полезности нейронов), чтобы сделать её восприимчивой для нового опыта.</li>
  <li><code class="language-plaintext highlighter-rouge">LoRA</code> - это реальный способ адаптации большой сетки к новому опыту. Тоже со счетов не сбрасываем.</li>
  <li><code class="language-plaintext highlighter-rouge">Hierarchical Reinforcement Learning, HRL</code>. Хотя этим идеям уже лет 30 (Dayan &amp; Hinton 1993, Feudal Reinforcement Learning), но всё равно можно каким-то наработками вдохновиться.</li>
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[После 12 октября охота за чемпионами усилилась. После 25-ой и 26-ой линеек (которые были в конце сентября) никак не получалось натренить агентов, которые бы проходили дальше 5-го уровня. Упирались засранцы и всё. была ставка, что нужно увеличить обзы. Ставка не сработала - заметка #136. дальше было подозрение, что новый VisionHead из 18d_world_model_09:183 какой-то бракованный. Однако, связка вижн хед VisionHead:183 + frostbite_07_old дала результаты. Выходит, что дело было не в VisionHead, а в батч-нормализация внутри вижн хеда наличие батч нормализации внутри вижн хеда вместе с неявным багом в использовании этого вижн хеда на оптимизации даёт положительный результат - на 3-ем шаге рождаются носители полезного навыка “умеют проходить 5-ый уровень. Выходит, что на роллауте агент играет с одними статистиками, близкими к тем, которые были на обучении WorldModel (уровни вплоть до 10-го), а на оптимизации использует статистика батча. И вот это расхождение вносит какую-то регуляризационную составляющую, которая приводит к рождению агентов носителей захотелось избавиться от этого бага, т.к. это а) неконтролируемая хрень б) не позволяет масштабировать длину входной цепочки. почему-то подумалось, что дело в забывчивостм агента. Это частично подтердилось тем, что через 18n_explore_03 стало ясно, что агент на третьем шаге разучился играть на 5-ом азбучном уровне. сделал эксперимент с постепенным расширением адресного пространства FFN (MLP) в трансформере политики. Типа на первом шаге доступно 1/6 адресов для записи и чтения. На втором шаге доступно следующая 1/6 адресов для записи и 2/6 для чтения и т.д. Идея была в сохранении накопленного опыта. Но идея проавалилась, т.к. FFN (MLP) не живёт изолированно, а зависит от того, что в том числе проиходит в Attention слоях. Т.к. слои внимания мутируют, то ключи в FFN слое теряют синхронизацию с выходами слоёв внимания и модель разваливается. поэтому сделал шаг в сторону LoRA архитектуры (frostbite_11). Это когда модель морозится но на MHA и FFN слои сверху нашлёпываются низкоранговые прослойки, которые впитывают новый опыт. Но в запуск это дело не пошло, т.к. стало понятно, что пока получение носителей на третьем шаге решено не будет LoRA будет преждевременным поэтому натренил новый вижн хед без батч-норма (VisionHead:294). Вместо батч-норма взял PixelNorm. 45-ая линейка исследований показала, что туго, но носители рождаются и можно дальше тренить потом подумалось, что можно взять под контроль батч-норм, если перенести его напрямую в энкодер. Идея сначала обломалась (46-линейка), так как была неправильная реализация энкодера (флаг is_ob_features_batch_norm не пробрасывался). Со второго раза получили новый энкодер (18d_world_model_10:29). Но выяснилось, что и для него нужен хак в виде постоянного передёргивания на параметры того, какой был в WorldModel - флаг is_world_model_ob_features_batch_norm. к 26 октября пришли с пониманием, что надо просто брать вижн хед без батч-норма, энкодер без батч-норма, убирать все эти долбанные хаки и просто за счёт чуть большего кол-ва ранов на 3-ем шаге получать носителей. Также на 5+ шагах даёт эффект расширения окна обзов (sequence_ages) ещё стало понятно после прочтения [DohareContLearn], что есть серьёзная проблематика с continual learning. На каждом шаге модель забывает старый опыт, и при этом плохо впитывает новый опыт. Именно поэтому азбука 5-го уровня на 3-ем шаге выветривается. Единственное, что спасает - это nine_lives в диете. Этот патч обеспечивает наличие в батчах оптимизации траекторий из всего спектра уровней. Поэтому агент как-бы умудряется сохранять опыть через этот костыль.]]></summary></entry><entry><title type="html">136) Больше памяти в лоб не работает</title><link href="https://kocherovms.github.io/2026/10/12/136.html" rel="alternate" type="text/html" title="136) Больше памяти в лоб не работает" /><published>2026-10-12T04:49:00+00:00</published><updated>2026-10-12T04:49:00+00:00</updated><id>https://kocherovms.github.io/2026/10/12/136</id><content type="html" xml:base="https://kocherovms.github.io/2026/10/12/136.html"><![CDATA[<p>С 1 октября я поставил на память. Гипотеза из #135: агенту не хватает не наблюдений, а времени. Окну на 4 кадра нечем связать гусей, льдины и смену уровня в один поток — для него это набор несвязанных мгновений. Идея была простая: расширить окно до 32, но не в лоб, а с хитростью — сначала учить на четырёх кадрах, потом морозить энкодер и открывать историю.</p>

<p>Первые 11 дней показали, что хитрость нужна не зря. Но и её мало.</p>

<p>&gt; между делом: те же 11 дней агент-ассистент получил больше памяти и разобрался с долговременным хранением. Забавно ставить задачи памяти модели мира ровно тогда, когда чинишь память у собственного цифрового коллеги.</p>

<p><strong>Что сделали с окном</strong></p>

<p>Собрал <code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_08</code>: длина истории теперь задаётся через <code class="language-plaintext highlighter-rouge">sequence_ages</code>, а временная разметка — синусоидальная, как в ванильном трансформере (Васвани и соавт., «Attention Is All You Need»). Уже это ставило вопрос: то же это самое «окно пошире» или другое качество.</p>

<p>Первый прогон — <code class="language-plaintext highlighter-rouge">18n_study_36.1</code> — был ещё на старой схеме. Новую <code class="language-plaintext highlighter-rouge">temporal_encoding</code> там не реализовали: работали старые learned-параметры, <code class="language-plaintext highlighter-rouge">sequence_ages</code> не использовался. То есть все 16 обзов каждый раз грузились агенту на ленту целиком. Честное «окно 16 против 4», без хитростей.</p>

<p>Результат неутешительный. Окно 16 значимо <strong>хуже</strong>: средняя 0.5561 против 0.6272 у бейзлайна с окном 4 (<code class="language-plaintext highlighter-rouge">18n_study_31.1</code>). Лучший агент с окном 16 (<code class="language-plaintext highlighter-rouge">25</code>) — 0.7594, лучший бейзлайн (<code class="language-plaintext highlighter-rouge">521</code>, <code class="language-plaintext highlighter-rouge">528</code>) — 0.7969.</p>

<p>Вывод: окно само по себе не лекарство. И дело, скорее всего, не в самой памяти как таковой, а во времени — чтобы научиться пользоваться более длинной историей, агенту, видимо, нужно заметно больше обучения. Пока окно 16 — это не «умнее», а «дороже».</p>

<p><strong>Модель мира: проблема была в данных</strong></p>

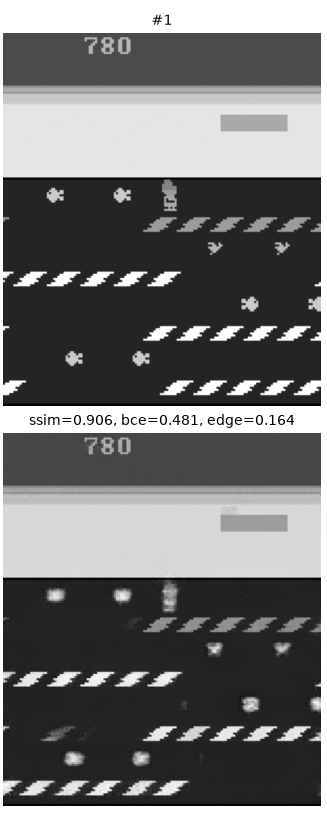
<p>Долго бились с системной проблемой <code class="language-plaintext highlighter-rouge">recon/0.1+recon/3.0</code> — модель неверно восстанавливала нижний ряд льдин.</p>

<p><img src="/assets/2026-10-12/recon-problem.png" width="327" /></p>

<p>Пробовали ёмкость <code class="language-plaintext highlighter-rouge">VisionHead</code> (24.1, 25.1), ёмкость и число слоёв <code class="language-plaintext highlighter-rouge">RenderHead</code> (26.1, 27.1), ширину <code class="language-plaintext highlighter-rouge">d_model</code> (28.1). Всё давало копейки и проблему не решало.</p>

<p>Разгадка пришла в <code class="language-plaintext highlighter-rouge">18d_study_30.1</code>: дело было не в модели, а в данных. Объединили текущие 16 датасетов с 12 из <code class="language-plaintext highlighter-rouge">18d_world_model_09:40</code> — итого 28 — и получили ssim 0.9905. Месяцы тюнинга архитектуры против правильно собранного датасета: датасет выиграл.</p>

<p>Дотренировали чемпионов (<code class="language-plaintext highlighter-rouge">18d_study_30.2</code>) — взяли <code class="language-plaintext highlighter-rouge">VisionHead</code> версии <code class="language-plaintext highlighter-rouge">183</code> (ssim 0.9936). На нём теперь строится вся 18n-линейка.</p>

<p><strong>Потолок третьего уровня</strong></p>

<p>Дальше — самое неприятное. На <code class="language-plaintext highlighter-rouge">183</code> собрали новый бейзлайн (<code class="language-plaintext highlighter-rouge">18n_study_31.1</code>), но чемпионы <code class="language-plaintext highlighter-rouge">18n_study_32</code> оказались сплошной посредственностью: все упёрлись в <code class="language-plaintext highlighter-rouge">levels_passed=3</code>. В сентябре мы брали 5 уровней (см. #133). Новый бейзлайн не дотягивает до старого — это и есть «хтонь» 34-й линейки, которую 34.3b–34.5 пытались продавить количеством прогонов. Не продавили.</p>

<p>Сквозной прогон <code class="language-plaintext highlighter-rouge">18n_study_35</code> вернул логику работы от обзов на оптимизации, как в старом <code class="language-plaintext highlighter-rouge">frostbite_07_old</code>. Дались жидкие прострелы (<code class="language-plaintext highlighter-rouge">18n_study_35.4</code> — 3.75), но не прорыв. Финальная попытка <code class="language-plaintext highlighter-rouge">18n_study_35.3d</code> — тот же третий шаг, но на старом коде — 3.0.</p>

<p>Вывод трезвый, без посыпания головы пеплом: низковисячие фрукты съедены. Простые рычаги — количество прогонов, анниллинг, логика обзов — дали своё, и дальше ими не выехать. Остаётся либо случайность, либо сам <code class="language-plaintext highlighter-rouge">VisionHead</code>. Значит, пора изобретать новые подходы, а не перебирать старое.</p>

<p><strong>Где угнетается исследование (спойлер: не сильно)</strong></p>

<p>Отдельная ветка — расследование <code class="language-plaintext highlighter-rouge">18n_study_23.3b–23.3n</code> вокруг AMP. Тут пришлось городить новый гипер <code class="language-plaintext highlighter-rouge">is_obs_usage_enforced</code>, чтобы воспроизвести логику старого <code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_07</code>: на роллауте без AMP, на оптимизации — с AMP, но с полной цепочкой <code class="language-plaintext highlighter-rouge">obs → VisionHead → Encoder → ob_latents</code>.</p>

<p><code class="language-plaintext highlighter-rouge">is_obs_usage_enforced</code> оказался очень коварным. Из-за него можно было неявно менять <code class="language-plaintext highlighter-rouge">VisionHead</code>, даже когда его обучение выключено. Дело в используемых внутри него <code class="language-plaintext highlighter-rouge">BatchNorm2d</code>. По-дефолту модель стоит в <code class="language-plaintext highlighter-rouge">train</code> режиме, и поэтому при прогоне батчей на оптимизации у неё меняются <code class="language-plaintext highlighter-rouge">running_mean</code>, <code class="language-plaintext highlighter-rouge">running_var</code>. А в прологе к оптимизации стояла строка:</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">if</span> <span class="n">RT</span><span class="p">.</span><span class="n">vision_head</span><span class="p">.</span><span class="n">is_trainable</span><span class="p">:</span> <span class="n">RT</span><span class="p">.</span><span class="n">vision_head</span><span class="p">.</span><span class="n">train</span><span class="p">()</span>
</code></pre></div></div>

<p>Т.е. получается, что без явного вызова <code class="language-plaintext highlighter-rouge">RT.vision_head.eval()</code> на оптимизации мы начинали менять <code class="language-plaintext highlighter-rouge">VisionHead</code> неявным образом!</p>

<p>Правильный код:</p>
<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">RT</span><span class="p">.</span><span class="n">vision_head</span><span class="p">.</span><span class="n">train</span><span class="p">(</span><span class="n">RT</span><span class="p">.</span><span class="n">vision_head</span><span class="p">.</span><span class="n">is_trainable</span><span class="p">)</span>
</code></pre></div></div>

<p>По-честному, выхлоп небольшой. И с <code class="language-plaintext highlighter-rouge">prediction_loss</code> не сказать, что эффект прямо такой уж сильный: убрали — хуже, вернули — лучше, но всё на грани шума. Скорее всего, дело опять-таки в самом <code class="language-plaintext highlighter-rouge">VisionHead</code> и в случайности.</p>

<p><strong>Разное</strong></p>

<p>Победили недетерминизм PPO: <code class="language-plaintext highlighter-rouge">torch.use_deterministic_algorithms(True)</code> + <code class="language-plaintext highlighter-rouge">cudnn.deterministic=True</code> + <code class="language-plaintext highlighter-rouge">cudnn.benchmark=False</code>, плюс дефолты по дропауту и шуму. Теперь запуски с одним <code class="language-plaintext highlighter-rouge">random_seed</code> сходятся до копейки — с этим проще сравнивать эксперименты.</p>

<p><strong>Что дальше</strong></p>

<ol>
  <li>Сфокусироваться на 8-обзовом варианте, где работают два timescale. Понять, помогает ли такая схема растить выдающихся чемпионов.</li>
  <li>Если не поможет — возвращаться к <code class="language-plaintext highlighter-rouge">VisionHead</code> версии <code class="language-plaintext highlighter-rouge">40</code> и заниматься регрессионной охотой.</li>
  <li><code class="language-plaintext highlighter-rouge">prediction_loss</code> оставить как есть: убедительных доказательств, что он что-то сильно портит, нет.</li>
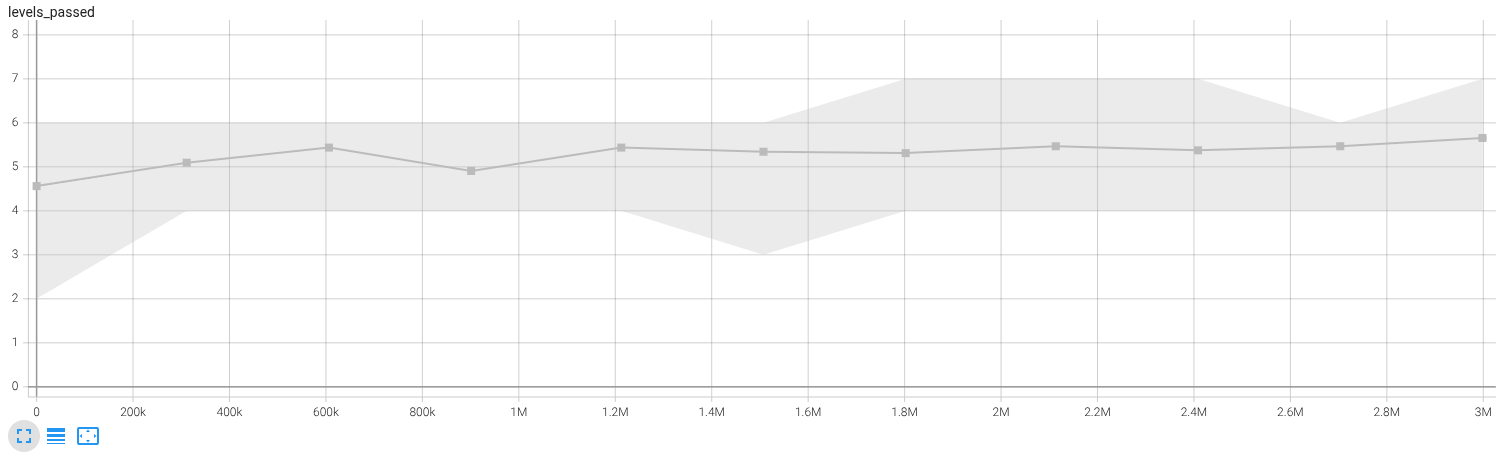
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[С 1 октября я поставил на память. Гипотеза из #135: агенту не хватает не наблюдений, а времени. Окну на 4 кадра нечем связать гусей, льдины и смену уровня в один поток — для него это набор несвязанных мгновений. Идея была простая: расширить окно до 32, но не в лоб, а с хитростью — сначала учить на четырёх кадрах, потом морозить энкодер и открывать историю.]]></summary></entry><entry><title type="html">135) больше памяти для агента</title><link href="https://kocherovms.github.io/2026/10/01/135.html" rel="alternate" type="text/html" title="135) больше памяти для агента" /><published>2026-10-01T07:54:00+00:00</published><updated>2026-10-01T07:54:00+00:00</updated><id>https://kocherovms.github.io/2026/10/01/135</id><content type="html" xml:base="https://kocherovms.github.io/2026/10/01/135.html"><![CDATA[<p>За прошедшие несколько дней окончательно перелез на <code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_07</code>. Теперь используется <code class="language-plaintext highlighter-rouge">TestManager</code> вместо видео захвата. <code class="language-plaintext highlighter-rouge">TestManager</code> делает 32 прогона вместо одного, что даёт более стабильные результаты. Также бонусом идут margin charts: вместе со средней величиной <code class="language-plaintext highlighter-rouge">levels_passed_mean</code> видны минимальные и максимальные границы. Например, тут видно, что <code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_07:330</code> в конце аж до 8-го уровня дошёл и уверенно преодолевает 5-уровней (средняя ближе к 6-ке).</p>

<p><img src="/assets/2026-10-01/levels_passed.png" /></p>

<p>В рамках <code class="language-plaintext highlighter-rouge">18n_study_26.6</code> и <code class="language-plaintext highlighter-rouge">18n_study_27.6</code> объявился феномен <strong>“горбатости”</strong>. Сначала агент преуспевает на поздних уровнях, а потом медленно деградирует. Связываю это с разучиваением. Типа если он проводит больше времени на поздних уровнях, то начинает забывать начальные. Эффект не катастрофический, т.к. мы заставляем его постоянно проходить начальные уровни и тем самым не даём политике развалится, но всё равно неприятный.</p>

<p>Ещё также обнаружился феномен <strong>двух фракций</strong>: одни агенты очень стабильно проходит первые уровни практически без потерь, но не так феерично играют на поздних уровнях, а другие наоборот - играют небрежно, могут сдохнуть где-нибудь на 3 или 4-ом уровне, но зато легче доходят до 8-го.</p>

<p>Чем можно победить разучивание? Кажется, что только памятью. Сейчас у агента что есть: 1) коротенькая tape-like память на 4 слота - текущие наблюдения, 2) память в MLP слоях трансфомера. Видимо в таком сетапе агенту некуда просто выгрузить нерелевантную для данного уровня информацию и наоборот, подгрузить, нужную. На ум приходят архитектуры, где есть какая-нибудь матричная память, DND, LSTM или GRU. Но какой-то цельной картины, как это встроить непонятно.</p>

<p>Что стало более понятно, так это то, что можно пока поработать с tape-like памятью - трансформенным окном. Сейчас это 4 наблюдения. Я считал, что т.к. игра fully-observable, то этого хватает. Джемини мне подпевал только. А теперь я понимаю следующее. Да, во Frostbite нет такого понятия, как неразведанная территория или fog of war, как в StarCraft. Но это не означает, что 4-х наблюдений хватит для построения оптимальной политики. Возьмем, например, гусей. Вот они улетели с одной стороны и что-то должно появиться с другой стороны: может рыбка, может крабы, может гуси. Если у агента только 4 наблюдения, то для него просто существует миг. Появление врагов с другой стороны будет для него сюрпризом. А вот если бы у агенты была хотя бы память на несколько секунд, то он мог бы это предвидеть и действовать более оптимально. То же самое и со льдинам.</p>

<p>Другая аналогия. Если у агента есть только 4 наблюдения, и агент бы обитался в нашем мире, то он никогда бы не смог понять смену дня и ночи, времён года да и вообще чего-бы то ни было, что не укладывается в этот промежуток времени. Т.к. каждый эпизод для него - это всего лишь 4 наблюдения. Для него день и ночь - это как будто всегда существующее состояние. Перехода между ними просто нет. И он действует как будто всегда ночь или всегда день. И только наличие памяти позволит зацепить эти переходы и понять, что есть более низкочастотные явления, чем передвижения льдинок или гусей на пару пикселей. А раз так, то и действия его могут быть более хитрыми.</p>

<p>Как быстро проверить? Решил, что пока не хочется ломать архитектуру сильно и превносить какие-то другие конструкции (LSTM, GRU). Думаю просто увеличить контекстное окно до 32. Это где-то около 5 секунда времени. Но если увеличить в лоб, то сразу агент начнёт жрать кучу памяти и обучение будет длиться вечность. Поэтому идём на хитрость. Делаем окно 32, но на роллауте собираем только 4 обза. Обучаем агента, боль-мень играть. Потом морозим энкодер (а это работает - см. <code class="language-plaintext highlighter-rouge">18n_study_26.6</code>), и открываем окно на полную. Т.е. в начале агент смотрит только на 4 обза (высокочастотное обучение), а потом получает доступ к более богатой истории. И по идее он должен стать более умным.</p>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[За прошедшие несколько дней окончательно перелез на 18n_ppo_tr_frostbite_07. Теперь используется TestManager вместо видео захвата. TestManager делает 32 прогона вместо одного, что даёт более стабильные результаты. Также бонусом идут margin charts: вместе со средней величиной levels_passed_mean видны минимальные и максимальные границы. Например, тут видно, что 18n_ppo_tr_frostbite_07:330 в конце аж до 8-го уровня дошёл и уверенно преодолевает 5-уровней (средняя ближе к 6-ке).]]></summary></entry><entry><title type="html">134) эволюция агента</title><link href="https://kocherovms.github.io/2026/09/24/134.html" rel="alternate" type="text/html" title="134) эволюция агента" /><published>2026-09-24T13:45:00+00:00</published><updated>2026-09-24T13:45:00+00:00</updated><id>https://kocherovms.github.io/2026/09/24/134</id><content type="html" xml:base="https://kocherovms.github.io/2026/09/24/134.html"><![CDATA[<table>
  <thead>
    <tr>
      <th>Начало обучения</th>
      <th>Конец обучения</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>пройдено уровней: 0</td>
      <td>пройдено уровней: 5</td>
    </tr>
    <tr>
      <td>очки: 200</td>
      <td>очки: 12410</td>
    </tr>
    <tr>
      <td>шагов обучения: 03 млн</td>
      <td>шагов обучения: 18 млн</td>
    </tr>
    <tr>
      <td><video controls="" onloadedmetadata="this.playbackRate=2.0;" src="/assets/2026-09-24/agent-416.mp4" style="width: 100%"></video></td>
      <td><video controls="" onloadedmetadata="this.playbackRate=2.0;" src="/assets/2026-09-24/agent-610.mp4" style="width: 100%"></video></td>
    </tr>
  </tbody>
</table>

<p><strong>Архитектура</strong></p>

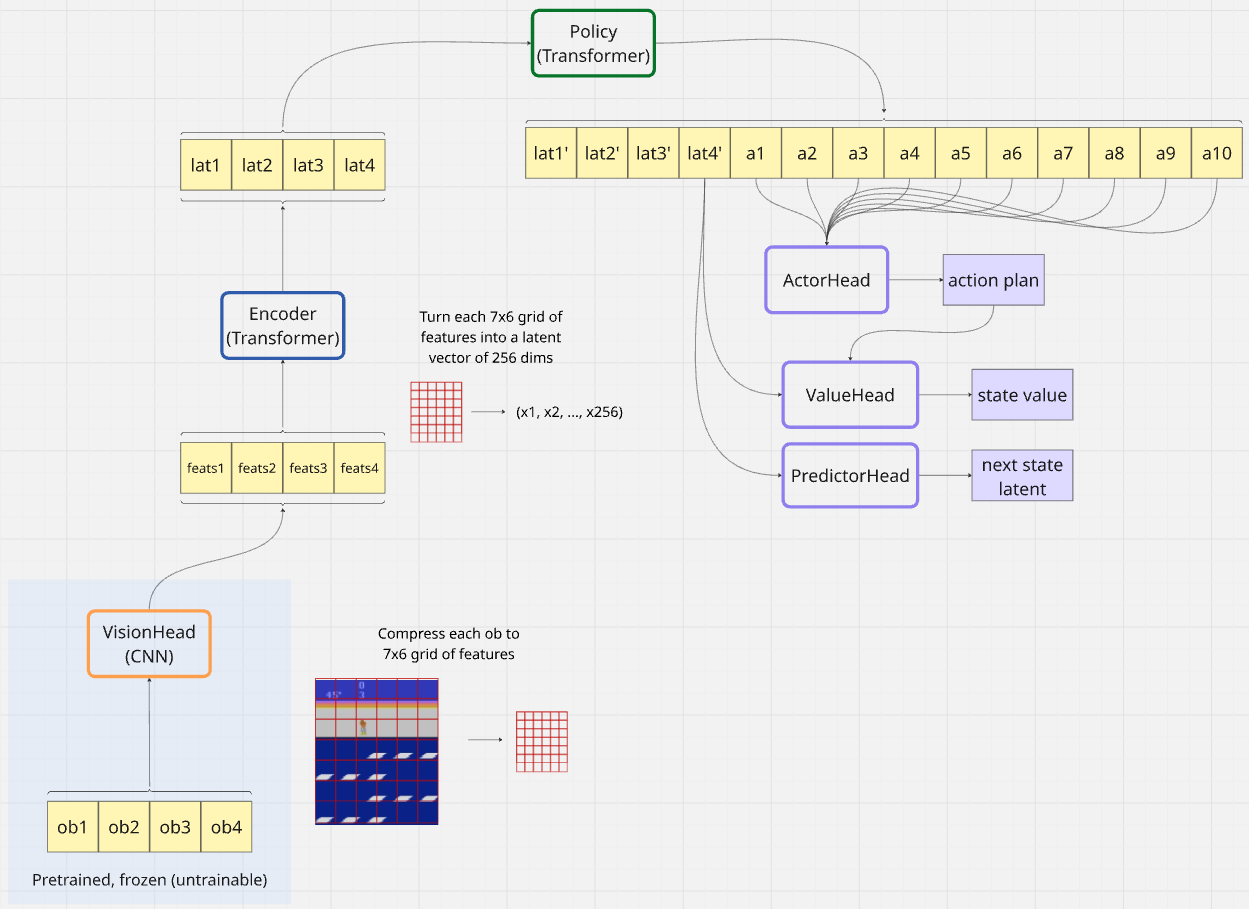
<p>На нижнем уровне <code class="language-plaintext highlighter-rouge">CNN</code> сетка. Далее идут два стэкированных трансформера: энкодер и полиси. Можно и без энкодера, но тогда в полиси сразу уедут 4 * 42 латента (квадратичная сложность), что сделает его очень медленным и очень требовательным к памяти. Поэтому промежуточный энкодер необходим. Полиси трансформер анализирует динамику и вычисляет латенты для будущего плана действий, предсказательный латент. Преобразованный латент последнего обза (<code class="language-plaintext highlighter-rouge">lat4'</code>) используется для оценки состояния через <code class="language-plaintext highlighter-rouge">ValueHead</code> (<code class="language-plaintext highlighter-rouge">Linear</code>). Следующее действие вычисляет <code class="language-plaintext highlighter-rouge">ActorHead</code> (<code class="language-plaintext highlighter-rouge">Linear</code>). Предсказанием будущего занимается <code class="language-plaintext highlighter-rouge">PredictorHead</code> (<code class="language-plaintext highlighter-rouge">MLP</code>).</p>

<p>Общее кол-во параметров: 5_081_479</p>

<p>Кол-во оптимизируемых параметров: 4_930_439</p>

<p><img src="/assets/2026-09-24/arch.png" /></p>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Начало обучения Конец обучения пройдено уровней: 0 пройдено уровней: 5 очки: 200 очки: 12410 шагов обучения: 03 млн шагов обучения: 18 млн]]></summary></entry><entry><title type="html">133) ЕСТЬ 5 УРОВНЕЙ, 18n_ppo_tr_frostbite_06!</title><link href="https://kocherovms.github.io/2026/09/22/133.html" rel="alternate" type="text/html" title="133) ЕСТЬ 5 УРОВНЕЙ, 18n_ppo_tr_frostbite_06!" /><published>2026-09-22T10:32:00+00:00</published><updated>2026-09-22T10:32:00+00:00</updated><id>https://kocherovms.github.io/2026/09/22/133</id><content type="html" xml:base="https://kocherovms.github.io/2026/09/22/133.html"><![CDATA[<p>Ну что, вот оно долгожданное событие! Агент самостоятельно смог пройти 5 уровней в Atari Frostbite. Хотя бы на принципиальном уровне решена проблема, поднимавшаяся в #126, #125, #123, #121.</p>

<p>Всё произошло в рамках <code class="language-plaintext highlighter-rouge">18n_study_18.5e</code>. Было три акта прохождения:</p>
<ul>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:355</code></li>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:359</code></li>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:369</code></li>
</ul>

<p>Обидно только, что это случилось в самом начале или в середине, а ближе к концу агенты даже немного деградировали. Но сам факт, что агент смог пройти 5 уровней - это то, над чем я бился несколько месяцев. Значит, ёмкость архитектуры позволяет агенту одолевать 5 уровней. Осталось только оптимизировать путь обучения и саму архитектуру, чтобы результат был стабильным.</p>

<p>Успех закреплён в <code class="language-plaintext highlighter-rouge">18n_study_19.6e</code>, тут уже побогаче:</p>
<ul>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:610</code> (два раза финальных)</li>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:607</code> (два раза)</li>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:609</code> (два раза)</li>
  <li><code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite_06:613</code> (один раз)</li>
</ul>

<p>Рефлексия по пройдённому пути с Atari Frostbite, что сработало:</p>
<ol>
  <li>трансформер прекрасно заменяет stacked frames. Трансформе по сути - это работа с памятью.</li>
  <li>там, где можно сломать joint, надо ломать. Например, spatial encoding - лучше сделать два отдельных экондинга по X,Y (separate), чем один объединённый (joint). Так модели нужно меньше учиться и это усиливает обобщающую способность</li>
  <li>как можно быстрее переходить на работу с латентами (что-то типа идей <code class="language-plaintext highlighter-rouge">JEPA</code>). Граундиться на обзервейшны (<code class="language-plaintext highlighter-rouge">RenderHead</code>), особенно для предсказания - это дохлый номер.</li>
  <li>стохастичность. На первых уровнях можно искусственно увеличивать стохастичность, чтобы способоствовать лучшему изучению пространства состояний. На более поздних уровнях искусственная стохастичность может мешать, т.к. а) стохастичнотсть уже и так встроена и б) сами по себе поздние уровние (например, 5-ый) уже и так достаточно сложные. Получается, что можно создать трейн РАМ-ы, которые очень сложны в прохождении. Из-за чего агент может даже деградировать, т.к. начнёт терять путевондуню нить - поток награды</li>
  <li>прохождение пятого уровня на видео захвате не гарантирует, что агент научился его проходить уверенно. Многое зависит от <code class="language-plaintext highlighter-rouge">random_seed</code>. Например, для <code class="language-plaintext highlighter-rouge">random_seed=64</code> агент будет проходить 5-ый уровень с 20% вероятность, а с <code class="language-plaintext highlighter-rouge">random_seed=61</code> - уже только с 5% вероятностью. Поэтому чтобы агент уверенно проходил 5-ый уровень, надо чтобы при обучении он проходил 6-ой уровень. Это типа как с тренировками: если пробегаешь полумарафон, то пробежать 10км - вообще ни о чём.</li>
  <li>полноцветный материал лучше серого: (3, 84, 84) » (1, 84, 84). Обучаемость на полном цвете идёт явно бодрее</li>
  <li>очень помогла декомпозиция <code class="language-plaintext highlighter-rouge">CNN + Transformer</code> на <code class="language-plaintext highlighter-rouge">CNN (VisionHead) + Encoder (Transformer) + Policy (Transformer)</code>. В первом случае вся тяжесть по кодированию обзов влетает в <code class="language-plaintext highlighter-rouge">CNN</code>, из-за чего его колбасит и агент забывает прошлый опыт при значительном переключении палитры (см. проблему дневной/ночной уровень). Во втором случае мы морозим <code class="language-plaintext highlighter-rouge">VisionHead</code> и заставляем тем самым перераспределить тяжесть логики вычисления латентного представления состояния на трансформеры.</li>
  <li>одного или двух запусков не хватает. Нужно минимум 10, а лучше больше, чтобы получить адекватное представление о распределении кривых эффективности агента. Есть является “зацепляемости” (traction) - взрывной роста эффективности агента случается при наступлении комбинации событий. А чтобы эту комбинацию поймать, нужно несколько запусков с разным рандом сид</li>
  <li>естественный отбор. Прошлый пункт сам собой предлагает путь, когда для обучения на следующем этапе отбираются самые эффективные агенты. Иначе так можно впустую жечь ресурсы. Да, всегда есть вероятность с водой выплеснуть и ребёнка (оставить не выбранным более агента, который бы себя позднее проявил), но это нерабочая схема из-за дороговизны ресурсов. Если бы ресурсов было бесконечно много, то можно было бы всех проверять, но это невозможно.</li>
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Ну что, вот оно долгожданное событие! Агент самостоятельно смог пройти 5 уровней в Atari Frostbite. Хотя бы на принципиальном уровне решена проблема, поднимавшаяся в #126, #125, #123, #121.]]></summary></entry><entry><title type="html">132) 18n_ppo_tr_frostbite_04 и 18n_ppo_tr_frostbite_05</title><link href="https://kocherovms.github.io/2026/09/17/132.html" rel="alternate" type="text/html" title="132) 18n_ppo_tr_frostbite_04 и 18n_ppo_tr_frostbite_05" /><published>2026-09-17T05:40:00+00:00</published><updated>2026-09-17T05:40:00+00:00</updated><id>https://kocherovms.github.io/2026/09/17/132</id><content type="html" xml:base="https://kocherovms.github.io/2026/09/17/132.html"><![CDATA[<p>Здесь прикручен энкодер из <code class="language-plaintext highlighter-rouge">18d_world_model_08</code>. С замороженным энкодером цикл обучения бежит быстро, и это радует - 20 минут на 6 млн. шагом. С другой стороны невооруженным глазом видно, что обучаемость идёт со скрипом. См. исследования: <code class="language-plaintext highlighter-rouge">18n_study_13.1</code>, <code class="language-plaintext highlighter-rouge">18n_study_14.1</code>, <code class="language-plaintext highlighter-rouge">18n_study_15.1</code>, <code class="language-plaintext highlighter-rouge">18n_study_16.1</code>, <code class="language-plaintext highlighter-rouge">18n_study_17.1</code>.</p>

<p>В исследовании <code class="language-plaintext highlighter-rouge">18n_study_17.1</code> энкодер был разморожен и обучаемость агента стала явно веселее - близко к той, что была в 17-ых агентах. Это заставляет думать, что энкодер, обученный для целей реконструкции / предсказания, не достаточен. Чего-то мозгу агента не хватает для выработки оптимальной стратегии поведения. Но вместе с тем, тренить сразу и мозг и энкодер - это ОЧЕНЬ долго и жрёт много памяти.</p>

<p>Получается такая ситуция:</p>

<table>
  <thead>
    <tr>
      <th>вариант</th>
      <th>обучаемость</th>
      <th>замещение опыта</th>
      <th>скорость обучения</th>
      <th>потребление памяти</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>17-ый агенты</td>
      <td>хорошая</td>
      <td>либо уровни 1-4, либо 5-6</td>
      <td>высокая</td>
      <td>низкая</td>
    </tr>
    <tr>
      <td>18-ые агенты, замороженный энкодер</td>
      <td>посредственная</td>
      <td>хз (не доходил)</td>
      <td>очень высокая</td>
      <td>очень низкая</td>
    </tr>
    <tr>
      <td>18-ые агенты, размороженный энкодер</td>
      <td>хорошая</td>
      <td>хз (не доходил)</td>
      <td>очень медленная</td>
      <td>очень высокая</td>
    </tr>
    <tr>
      <td>18-ые агенты, чередование разморозки/заморозки</td>
      <td>посредственная</td>
      <td>хз (не доходил)</td>
      <td>медленно</td>
      <td>выше среднего</td>
    </tr>
  </tbody>
</table>

<p><strong>Выводы:</strong></p>
<ol>
  <li>уверенное продвижение вперёд пока может обеспечить только вариант, когда энкодер (какой-был он ни был: встроенный или факторизованный), обучается вместе с политкой (мозгами).</li>
  <li>17-ые агенты были покинуты из-за проблемы замещения опыта. Проблему замещения опыта хотелось решить факторизацией энкодера с его заморозкой</li>
  <li>значит, надо решить проблему замещения как-то иначе нежели простой заморозкой</li>
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Здесь прикручен энкодер из 18d_world_model_08. С замороженным энкодером цикл обучения бежит быстро, и это радует - 20 минут на 6 млн. шагом. С другой стороны невооруженным глазом видно, что обучаемость идёт со скрипом. См. исследования: 18n_study_13.1, 18n_study_14.1, 18n_study_15.1, 18n_study_16.1, 18n_study_17.1.]]></summary></entry><entry><title type="html">131) 18d_world_model_07: факторизованная модель мира</title><link href="https://kocherovms.github.io/2026/09/10/131.html" rel="alternate" type="text/html" title="131) 18d_world_model_07: факторизованная модель мира" /><published>2026-09-10T19:01:00+00:00</published><updated>2026-09-10T19:01:00+00:00</updated><id>https://kocherovms.github.io/2026/09/10/131</id><content type="html" xml:base="https://kocherovms.github.io/2026/09/10/131.html"><![CDATA[<p>Явное разделение <code class="language-plaintext highlighter-rouge">WorldModel</code> на:</p>
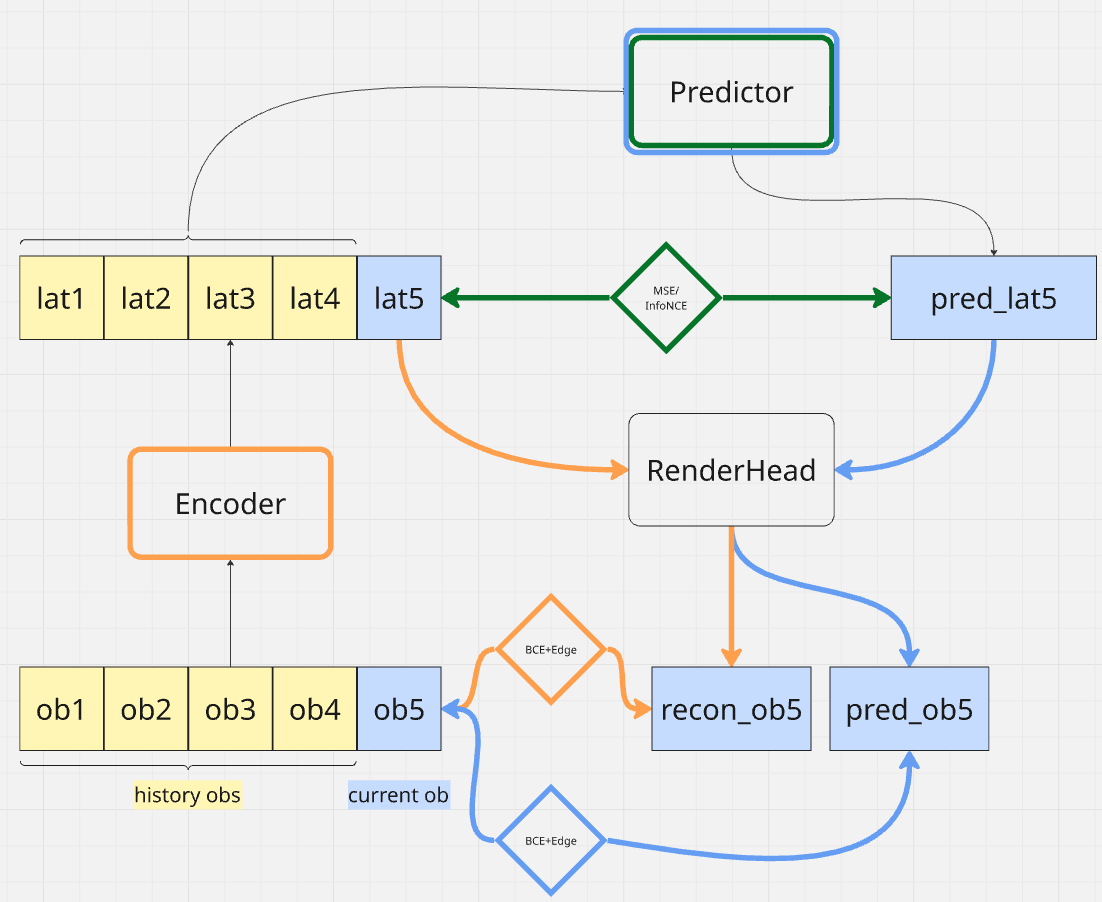
<ul>
  <li><code class="language-plaintext highlighter-rouge">Encoder</code> - переводит обз. (178,152) в латентный вектор (256). Использует внутри <code class="language-plaintext highlighter-rouge">VisionHead</code>, который CNN 6x6</li>
  <li><code class="language-plaintext highlighter-rouge">Predictor</code> - потребляет цепочку латентов от энкодера и на их основе предсказывает латент следующего обза.</li>
  <li><code class="language-plaintext highlighter-rouge">RenderHead</code> - принимает на вход латенты и по ним возвращает обз. (178,152).</li>
</ul>

<p>Цель была в том, чтобы легко унести <code class="language-plaintext highlighter-rouge">Encoder</code> в <code class="language-plaintext highlighter-rouge">18n_ppo_tr_frostbite</code> и там использовать сравнение латентов, вместо рендеринга. Это откроет возможности для использования более длинных цепочек и тем самым решить проблемы тупизны агента, когда он не может разобраться с тем, он сдох или это очистка уровня идёт.</p>

<p>Как ни странно, для сравнения латентов подходит обычный <code class="language-plaintext highlighter-rouge">MSE</code>. Ещё пробовал <code class="language-plaintext highlighter-rouge">InfoNCE</code>. Штука красивая, но требует ещё доп. прожектор и по <code class="language-plaintext highlighter-rouge">ssim</code>, ниже чем <code class="language-plaintext highlighter-rouge">MSE</code>. См. исследования <code class="language-plaintext highlighter-rouge">18d_study_14.1</code>, <code class="language-plaintext highlighter-rouge">18d_study_15.1</code>, <code class="language-plaintext highlighter-rouge">18d_study_15a.1</code>, <code class="language-plaintext highlighter-rouge">18d_study_16.1</code>, <code class="language-plaintext highlighter-rouge">18d_study_17.1</code>.</p>

<p><img src="/assets/2026-09-10/arch.png" width="800" /></p>

<p>Из важного:</p>
<ol>
  <li>для обучения энкодера оказалось достаточно последнего обза из секва. До этого прогонял все обзы, но это просто увеличивалос время тренинга, НЕ добавляя в качестве. По факту я просто брал датасет, умножал каждый элемент на 4, и прогонял этот датасет. Понятно, что на распределение это никак не влияет, а только влияет на время и потребление памяти. Короче, как только перешёл на использование только последнего обза из секва, сразу скорость в небеса.</li>
  <li>сравнение латентов VS сравнение через рендеринг. По скорости - небо и земля. Однозначно надо держаться за сравнение латентов, правда тут возникает вопрос - а вот где та граница, когда два латента достаточно хороши? Короче проблема граундинга, надо как-то цепочку до реальности простраивать, иначе можно (особенно при иерархической конструкции) фантазировать латентами, которые ничего общего с реальностью не имеют.</li>
  <li>фокусность. Возможно проблема граундинга можно решить не тем, чтобы с пиксель-перфект качеством рендерить обзы, а с тем, чтобы уметь рендерить небольшой кусочек обза. Это схоже с тем, как мы думаем о будущем. Мы не можем думать о всём сразу, мы можем думать и воображать о чём-то одном. И потом из этих частей можно сложить уже полную картинку. А вот сразу всё - это не охватывается.</li>
  <li>горизонт воображения. С предсказанием следующего обза есть проблема слишком короткого горизонта - порядка 0,13сек. За это время редко когда меняется позиция игрока, врагов. Чаще они просто меняет своё состояние: кралья вверх или вниз, ножки подогнуты или вытянуты. А если позиция и меняется, то незначительно. Поэтому модель может просто это обойти тем, чтобы рисовать что-то размыленное в пределах ожидамой границы перемещения. Поэтому интересно посмотреть, как будет на более длинном горизонте предсказание работать. Например, предсказывать, что будет через +1 сек.</li>
  <li>возникла мысль, что можно стэкировать предсказатели. И их отдельно обучать. И что каждый предсказатель потребялет латенты нижележащего.</li>
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Явное разделение WorldModel на: Encoder - переводит обз. (178,152) в латентный вектор (256). Использует внутри VisionHead, который CNN 6x6 Predictor - потребляет цепочку латентов от энкодера и на их основе предсказывает латент следующего обза. RenderHead - принимает на вход латенты и по ним возвращает обз. (178,152).]]></summary></entry><entry><title type="html">130) находки 18n_ppo_tr_frostbite_02</title><link href="https://kocherovms.github.io/2026/09/02/130.html" rel="alternate" type="text/html" title="130) находки 18n_ppo_tr_frostbite_02" /><published>2026-09-02T08:10:00+00:00</published><updated>2026-09-02T08:10:00+00:00</updated><id>https://kocherovms.github.io/2026/09/02/130</id><content type="html" xml:base="https://kocherovms.github.io/2026/09/02/130.html"><![CDATA[<p>Данный агент использует <code class="language-plaintext highlighter-rouge">VisionHead</code> и <code class="language-plaintext highlighter-rouge">RenderHeads</code> из <code class="language-plaintext highlighter-rouge">18d_world_model_03:1</code>. Веса <code class="language-plaintext highlighter-rouge">VisionHead</code> и <code class="language-plaintext highlighter-rouge">RenderHeads</code> заморожены. В целом работает.</p>

<p>Проблемы:</p>
<ul>
  <li>жрётся ощутимо больше памяти, чем 17-е агенты. Ну это и понятно - 17-ый агент оперировал цепочкой из 4-х токенов, а здесь сразу в 36 раз больше</li>
  <li>как следствие время роллаута и оптимизации тоже выросли. 6 млн шагов 2,5 часа требует =(</li>
</ul>

<p>В ходе запусков выяснились интересные подробности:</p>
<ol>
  <li>в <code class="language-plaintext highlighter-rouge">ale</code> был баг в логике <code class="language-plaintext highlighter-rouge">Frostbite</code>, который приводил к тому, что игра переходила в режим скринсейвера. В итоге агент видел разворачивающееся действие, но нажатие кнопнок не давало никакого эффекта (). Агент познаёт безнадёгу, т.к. понимает, что от него ничего не зависит. Воспроизведение элементарное - надо, чтобы агент замёрз на последней жизни. Пофикшено в <code class="language-plaintext highlighter-rouge">ale_py=0.12.0+neurolab3</code></li>
  <li>после фикса бага вылез другой баг. Теперь если агент заходит в иглу на последней жизни, то ошибочно вздёргивался флаг <code class="language-plaintext highlighter-rouge">terminated</code>. Это всё из-зи того, что есть промежуточное состояние игры, в котором начисляются очки (levels clearance). А они начисляются с обратным отсчётом температуры. А в <code class="language-plaintext highlighter-rouge">ale_py=0.12.0+neurolab3</code> я незамысловато поставил, что если жизнь последняя и температура упала до 0, то вздёрнуть флаг <code class="language-plaintext highlighter-rouge">terminated</code>. Короче, оба бага пофикшены в <code class="language-plaintext highlighter-rouge">ale_py=0.12.0+neurolab4</code></li>
  <li><code class="language-plaintext highlighter-rouge">prediction_coef=0.1</code>, который хорошо работал для 17-ых агентов, стал приводить к вырожденному поведению в 18-ых агентах. Оказалось, что это слишком высокое значение, из-за которого агент предпочитает абсолютную предсказуемость. А она достигается, если просто стоять или делать простые механические движения. Почему значение коэффициента работало в 17-ых, и сломалось в 18-ых? Потому что в 17-х мы предсказывали эмбеддинг вектор (latent space), а 18-ых мы предсказываем пиксели. В итоге коэффициент по разному влияет на градиенты.</li>
  <li>градиенты. Добавил выгрузку в тензорборд влияния того или иного лосса на градиент. Выяснилось, что, действительно, снижение <code class="language-plaintext highlighter-rouge">prediction_coef</code> с 0.1 до 0.02 снижает влияние лосса по предсказанию на несколько порядков. Т.е. связь нелинейная.</li>
  <li>после получения вклада каждого лосса в градиенты выяснилось, что доминирующее значение вносит велью-лосс. Стал разбираться почему. Выяснилось, что есть агента колбасит туда-сюда, когда он утонет или пройдёт уровень. В обоих случая во входящей цепочке из 4-х картинок он видит статичную сцены, где ничего не двигается. И в итоге не может понять: это идёт начисление очков или это он утонул. И вот видно, чтоб если он думает, что идёт начисление очков и агент предполагает, что сейчас он нахоботит 40 очков, а по факту 2. И лосс просто громадные получается. Система такая: так, тащим влево. А потом следующий пример из батча: когда агент думает, что он сейчас нахоботит 20, а получает 30. И система такая: так, тащим вправо. Короче, великий тяни-толкай из-за того, что агент лишён возможности комплексно оценить обстановку. Я изначально думал, что 4-х кадров хватит. Да, этого хватит для активных игровых действий, но тут есть вот эти промежуточные состояния (начисление очков, анимация утопленности), которые на коротких цепочках сложно (если не невозможно) выявить.</li>
</ol>

<p>Мораль-то какая.</p>
<ol>
  <li>Без чистого сигнала агенту очень туго приходится. Выясняется, что всё это время я тренировал агента на грязных сигналах.</li>
  <li>Цепочка из 4-х наблюдений - этого недостаточно для Frostbite. Нужно 8-м. Либо нужно решать задачу по типу Transformer-XL, где мы анализируем эмбеддинг вектора.</li>
  <li>Нужно внимательно смотреть на градиенты, чтобы правильно выставить веса потерь.</li>
  <li>Если лосс колбасит, то это верный признак, что что-то идёт не так и надо с этим разбираться.</li>
</ol>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Данный агент использует VisionHead и RenderHeads из 18d_world_model_03:1. Веса VisionHead и RenderHeads заморожены. В целом работает.]]></summary></entry><entry><title type="html">129) 18d_world_model_01</title><link href="https://kocherovms.github.io/2026/08/21/129.html" rel="alternate" type="text/html" title="129) 18d_world_model_01" /><published>2026-08-21T08:14:00+00:00</published><updated>2026-08-21T08:14:00+00:00</updated><id>https://kocherovms.github.io/2026/08/21/129</id><content type="html" xml:base="https://kocherovms.github.io/2026/08/21/129.html"><![CDATA[<p>Промежуточный шаг для разработки нового агента. Объединение <code class="language-plaintext highlighter-rouge">18b_world_model</code> и <code class="language-plaintext highlighter-rouge">18c_world_model</code>. Т.е. эта модель умеет как в reconstruction, так и в prediction. Причем как порознь, так и одновременно.</p>

<p>Теперь, если потребуется при разработке агента потребуется поиграться с поиском оптимальных вариантов организации зрения, то можно использовать <code class="language-plaintext highlighter-rouge">18d_world_model</code>.</p>

<p>Из главного:</p>
<ol>
  <li>модель, когда одновременно и восстановление, и предсказание, показывает более высокий SSIM. Т.е. оба процесса дополняют друг друга.</li>
  <li>увеличение длины цепочки с 4 до 5 или даже до 7 не даёт ожидаемого улучшения SSIM (16, 17, 18, 19, 20, 21). Даже наоборот, имеем более низкие значения SSIM.</li>
  <li>увеличение сложности модели через heads_count и layers_count также не даёт улучшения по SSIM</li>
  <li>сетка 6x6 даёт хорошние результаты по SSIM (<code class="language-plaintext highlighter-rouge">18d_world_model_01/13</code> + <code class="language-plaintext highlighter-rouge">18d_world_model_01/14</code>)</li>
</ol>

<p>Самое большое удивление вызывает 2. Я думал, что чем длиннее цепочка, тем эффективнее будет модель. Интересно разобраться в причинах этого явления, но пока оставим, т.к. надо скорее девелопировать новый агент.</p>

<p>Короче, берём наработки из 18d и девелопируем новый агент.</p>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Промежуточный шаг для разработки нового агента. Объединение 18b_world_model и 18c_world_model. Т.е. эта модель умеет как в reconstruction, так и в prediction. Причем как порознь, так и одновременно.]]></summary></entry><entry><title type="html">128) 18c_world_model_02</title><link href="https://kocherovms.github.io/2026/08/19/128.html" rel="alternate" type="text/html" title="128) 18c_world_model_02" /><published>2026-08-19T06:59:00+00:00</published><updated>2026-08-19T06:59:00+00:00</updated><id>https://kocherovms.github.io/2026/08/19/128</id><content type="html" xml:base="https://kocherovms.github.io/2026/08/19/128.html"><![CDATA[<p>Продолжение №127.</p>
<blockquote>
  <p>So I came to idea that I need a more complex pipeline:</p>

  <p>foveal point selector. This is a rough CNN (e.g. 4x4 grid) coupled with simple transformer. Goal: given observation produce number of foveal points (configurable parameter) in terms of x,y,std(x),std(y). I.e. produce parameters of Gaussian distribution from one could sample.</p>

  <p>spatial feature extractor. Given sampled foveal points for each observation extract features with different resolution. I think I just need two resolutions: fine-grained (e.g. 5x5) and middle-grained (e.g. 4.4) with extended area. Observation space is not so large (it’s not a Starcraft observations) to use 3 or more resolution grades.
so I end up with a bunch of feature tokens for each observation which I label with temporal label and spatial labels. The remaining part of model is unchanged for now.</p>
</blockquote>

<p>Хотелось научиться работать многофокальными данными, когда есть несколько точек зрения на один кадр и потом через трансформер всё это изучается в целостности.</p>

<p>Провеёл несколько экспериментов для сетапа, когда есть 1 обзервейшн и нет pov_vision_head. Т.е. чисто за счёт ob_vision_head. Эксперименты:</p>

<table>
  <thead>
    <tr>
      <th>эксперимент</th>
      <th>особенность</th>
      <th>ssim</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>18c_world_model_02/1</td>
      <td>‘ob_vision_head’: {‘grid’: (6, 6), ‘features_counts’: (2, 4, 8, 16)}</td>
      <td>0.963</td>
    </tr>
    <tr>
      <td>18c_world_model_02/2</td>
      <td>‘ob_vision_head’: {‘grid’: (7, 7), ‘features_counts’: (2, 4, 8, 16)}</td>
      <td>0.9567</td>
    </tr>
    <tr>
      <td>18c_world_model_02/3</td>
      <td>‘ob_vision_head’: {‘grid’: (9, 9), ‘features_counts’: (2, 4, 8, 16)}</td>
      <td>0.9618</td>
    </tr>
    <tr>
      <td>18c_world_model_02/4</td>
      <td>‘ob_vision_head’: {‘grid’: (6, 6), ‘features_counts’: (4, 8, 16, 32)}</td>
      <td>0.9546</td>
    </tr>
    <tr>
      <td>18c_world_model_02/5</td>
      <td>‘ob_vision_head’: {‘grid’: (7, 7), ‘features_counts’: (4, 8, 16, 32)}</td>
      <td>0.9607</td>
    </tr>
    <tr>
      <td>18c_world_model_02/6</td>
      <td>‘ob_vision_head’: {‘grid’: (9, 9), ‘features_counts’: (4, 8, 16, 32)}</td>
      <td>0.9653</td>
    </tr>
    <tr>
      <td>18c_world_model_02/7</td>
      <td>‘ob_vision_head’: {‘grid’: (6, 6), ‘features_counts’: (8, 16, 32, 64)}</td>
      <td>0.9682</td>
    </tr>
    <tr>
      <td>18c_world_model_02/8</td>
      <td>‘ob_vision_head’: {‘grid’: (7, 7), ‘features_counts’: (8, 16, 32, 64)}</td>
      <td>0.969</td>
    </tr>
    <tr>
      <td>18c_world_model_02/9</td>
      <td>‘ob_vision_head’: {‘grid’: (9, 9), ‘features_counts’: (8, 16, 32, 64)}</td>
      <td>0.9608</td>
    </tr>
    <tr>
      <td>18c_world_model_02/10</td>
      <td>‘ob_vision_head’: {‘grid’: (6, 6), ‘features_counts’: (16, 32, 64, 128)}</td>
      <td><strong>0.9723</strong></td>
    </tr>
    <tr>
      <td>18c_world_model_02/11</td>
      <td>‘ob_vision_head’: {‘grid’: (7, 7), ‘features_counts’: (16, 32, 64, 128)}</td>
      <td>0.9693</td>
    </tr>
    <tr>
      <td>18c_world_model_02/12</td>
      <td>‘ob_vision_head’: {‘grid’: (9, 9), ‘features_counts’: (16, 32, 64, 128)}</td>
      <td>0.9711</td>
    </tr>
    <tr>
      <td>18c_world_model_02/13</td>
      <td>‘ob_vision_head’: {‘grid’: (6, 6), ‘features_counts’: (16, 32, 64, 128)}, ‘batch_size’: 256</td>
      <td>0.9613</td>
    </tr>
    <tr>
      <td>18c_world_model_02/14</td>
      <td>‘ob_vision_head’: {‘grid’: (9, 9), ‘features_counts’: (16, 32, 64, 128)}, ‘batch_size’: 256</td>
      <td>0.957</td>
    </tr>
  </tbody>
</table>

<p>Я думал, что чем больше грид и чем больше фичей, тем лучше. Но нет - как ни сранно 6х6 делает и 7х7 и 9х9 по крайней мере на первых 100 эпохах.</p>

<p>Дальше 4 обзервейшна, 2 пова, ob_vision_head выключен. База - это <code class="language-plaintext highlighter-rouge">'pov_vision_head': {'grid': (5, 5), 'features_counts': (16, 32, 64)}</code> Эксперименты:
|эксперимент|особенность|ssim|
|—|—|—|
|18c_world_model_02/15|-|0.8936|
|18c_world_model_02/16|’parent’: ‘18c_world_model_02:15’, ‘learn_rate’: ‘const(0.0001)’|<strong>0.9037</strong>|
|18c_world_model_02/17|’parent’: ‘18c_world_model_02:15’, ‘learn_rate’: ‘const(0.00025)’|0.8989|
|18c_world_model_02/18|’parent’: ‘18c_world_model_02:15’, ‘learn_rate’: ‘const(0.00005)’|0.8994|
|18c_world_model_02/19|’pov_coords_encoding’: {‘frequencies_count’: 16, ‘inner_d_model’: 64}|0.8855|
|18c_world_model_02/20|’pov_coords_encoding’: {‘frequencies_count’: 6, ‘inner_d_model’: 128}|0.8775|
|18c_world_model_02/21|’pov_coord_lists’: ‘pov_coord_lists:1:cls=2,0_526,49753,0_2’}|0.9026|
|18c_world_model_02/22|’pov_coord_lists’: ‘pov_coord_lists:1:cls=2,0_526,49753,0_2’}, ‘pov_coords_encoding’: {‘frequencies_count’: 6, ‘inner_d_model’: 64, ‘is_combined’: False}|<strong>0.9053</strong>|
|18c_world_model_02/23|’pov_coord_lists’: ‘pov_coord_lists:1:cls=2,0_526,49742’}, ‘pov_coords_encoding’: {‘frequencies_count’: 6, ‘inner_d_model’: 64, ‘is_combined’: False}|0.8806|
|18c_world_model_02/24|’pov_vision_head’: {‘grid’: (5, 5), ‘features_counts’: (32, 64, 128)}, ‘pov_coord_lists’: ‘pov_coord_lists:1:cls=2,0_526,49742’}, ‘pov_coords_encoding’: {‘frequencies_count’: 6, ‘inner_d_model’: 64, ‘is_combined’: True}|0.8711|
|18c_world_model_02/25|’comment’: ‘removed BatchNorm2d in pov_vision_head’, ‘pov_vision_head’: {‘grid’: (5, 5), ‘features_counts’: (32, 64, 128)}, ‘pov_coord_lists’: ‘pov_coord_lists:1:cls=2,0_526,49742’}, ‘pov_coords_encoding’: {‘frequencies_count’: 6, ‘inner_d_model’: 64, ‘is_combined’: True}|0.8924|</p>

<p>Сначала меня смутил низкий ssim, особенно на фоне предыдущих экспериментов. Даже после дообучения лучший был 0.9037. Возникла мысля, что это из-за хитроумного PovCoordsEncoding, который сразу и X, и Y смешивает в один эмбеддинг. Попробовал несколько эксперментов, где использовались различные эмбеддинги для X и Y (is_combined=False), также пробовал с гранулярными pov_coords (гранулярность 0.2, гранулярность исключает непрерывность, что делает изучение X,Y проще). Стало чуть получше, но не убедительно. После визуального просмотра обратил внимание на то, что модель плодит сразу несколько врагов в ряду. Т.е. как будто для неё выгодно в случае отсутствия информации нарисовать хоть что-то, т.к. это видимо просто снижает ошибку. Поэтому возникла мысль, что видимо в таком сетапе (рандомные pov_coords, нет общего контектса) м.б. лучше и не получить.</p>

<blockquote>
  <p>Ок. А что если совместить ob_vision_head и pov_vision_head, как собственно и задумывалось изначально? Это был эксп 18c_world_model_02/26, ssim=0.979.</p>
</blockquote>

<blockquote>
  <p>Не сказать, чтобы был какой-то прорыв. Конечно, за счёт грамотной раскладки POV должно быть возможным вырасти ssim. Но это надо девелопировать foveal point selector либо хардкодтить. Стоит ли оно того?</p>
</blockquote>

<p>Потом возникла мысль, а может быть и не нужны отдельные pov? Может просто хватит ob_vision_head на каждый из элементов сиквенса. Это, конечно, в каком-то роде декаденс, т.к. возвращает к тому сетапу, который был в №127. Правда там было 16х16х4=1024 токена, а здесь будет меньше.
|эксперимент|сетка|токенов|ssim|
|—|—|—|—|
|18c_world_model_02/27|6x6|144|0.9757|
|18c_world_model_02/29|7x7|196|0.9746|
|18c_world_model_02/30|9x9|324|0.9814|</p>

<p>Потом следующая мысль! А может стерео зрение попробовать? Это когда один обзервейшн исследуется двумя CNN (2x178х178-&gt;6x6, 72 токена), но с разными смещениями по оси Х. Так же смотрим что лучше работает: когда одна CNN для лева и права (сильная регуляризация), или когда разные (выше гибкость). Был выточен <code class="language-plaintext highlighter-rouge">18c_study_01</code>. Результаты:
|эксперимент|offset|is_shared|ssim|
|—|—|—|—|
|18c_world_model_02/opt_01/60|1|F|0.9777|
|18c_world_model_02/opt_01/56|2|F|0.9741|
|18c_world_model_02/opt_01/57|3|F|0.9799|
|18c_world_model_02/opt_01/52|4|F|0.9744|
|18c_world_model_02/opt_01/54|5|F|0.9751|
|18c_world_model_02/opt_01/59|1|T|0.9751|
|18c_world_model_02/opt_01/55|2|T|0.9785|
|18c_world_model_02/opt_01/51|3|T|0.9778|
|18c_world_model_02/opt_01/58|4|T|<strong>0.9818</strong>|
|18c_world_model_02/opt_01/62|5|T|0.9775|</p>

<p>Не, ну какое-то улучшение есть, по сравнению с тем, когда на один кадр одна CNN (один ob_vision_head). Вопрос только в цене: 32 токена против 72 (для 6х6).</p>

<p>Вообще упражняться тут долго можно:</p>
<ol>
  <li>ob_vision_head на последний кадр. На предыдущие кадры горизонтальные band-like CNN (9x1), чтобы точнее фиксировать горизонтальное движения</li>
  <li>харкодное расположение pov_vision_head в заранее определённых местах</li>
  <li>foveal point selector, как и задумывалось</li>
  <li>и т.д.</li>
</ol>

<p>Но, кажется, это немного отвлекает от главной задачи. А именно №126. Всё таки хочется научить агента проходить игру. Пока стало понятно, что надо заменять в агенте CNN, например, на 6х6. Короче, с новым опытом и наработками возвращаемся к агенту. Переделываем ему зрение, экспериментируем. Если будет не хватать, то можно вернуться к экспериментам world_model и найти ещё более оптимальную CNN. А если хватит и простой 6x6, то зачем усложнять?</p>]]></content><author><name>Михаил Кочеров</name></author><summary type="html"><![CDATA[Продолжение №127. So I came to idea that I need a more complex pipeline: foveal point selector. This is a rough CNN (e.g. 4x4 grid) coupled with simple transformer. Goal: given observation produce number of foveal points (configurable parameter) in terms of x,y,std(x),std(y). I.e. produce parameters of Gaussian distribution from one could sample. spatial feature extractor. Given sampled foveal points for each observation extract features with different resolution. I think I just need two resolutions: fine-grained (e.g. 5x5) and middle-grained (e.g. 4.4) with extended area. Observation space is not so large (it’s not a Starcraft observations) to use 3 or more resolution grades. so I end up with a bunch of feature tokens for each observation which I label with temporal label and spatial labels. The remaining part of model is unchanged for now.]]></summary></entry></feed>