60) необходимость абстрагирования
Несколько дней пытался подойти к написанию кода в рамках POC алфавита фичей (см. заметку 57). По-ходу размышлений подход немного трансформировался - вероятно сказалось влияние теории фреймов Минского [MMinskyFrmwrkReprKnowldg], статьи Kulpa про символьное кодирование “невозможных” фигур [ZKulpaPutOrdImpos], а также наблюдения за воронами, бродившими по крыше (типа что такое ворона, как наш мозг это понимает).
Итак, мысль про ПОК развилась до следующего. Пусть мы смотрим на цифру 5 или 6. Наш мозг подсознательно и автоматически генерит высказывания (utterances) типа “в верхней части фигуры есть горизонтальная палочка”, “под ней выпуклая область”, “слева от неё находится вертикальная палочка” и т.д. По идее такие высказывания могут быть представлены в виде строки символов из некоторого алфавита. Наиболее часто встречающиеся строки могут быть запомнены. Таким образом циферка 5 или 6 будет представлена в виде набора строк. Каждую строку можно назвать фичей. Таким образом мы будем накапливать фичи. Если взять бинарный вектор и каждый разряд сопоставить с какой-то фичей, то можно получить кодировку той или иной фигурки. Далее уже через кондишнинг МНР можно даже по части вектора пытаться понять, что за фигурка перед нами. Т.е. потом смотря на часть фигурки, получить набор высказваний, и по нему уже прийти к пониманию, что это за фигурка.
Касательно структуры высказваний. Так или иначе в высказвании придётся описывать местоположения (локации). “в верхней части…” - что значит верхняя часть? Где она начинается и заканчивается? “слева от нее” - как далеко это лево и т.д.. После долгих размышлений пришёл к выводу, что должно сработать следующее. Высказывание состоит из описания опорной точки (“в верхней части находится горизонтальная палочка”), а дальше следует какое-то относительное утверждение (“слева от которой есть вертикальная палочка”). Вот первая часть описывается в виде ординальных позиций (например, у нас может быть всего 4 позиции: NW, NE, SE, SW) относительно центра фрейма, вторая часть - уже относительно локации опорной точки.
Учитывая, что после упражнений с севенсингом все фигурки у нас векторизированы, и могут быть описаны в виде векторов, то с генерацией подобного рода высказываний проблем быть не должно. И всё равно как-то не поднималась рука начать писать и вот почему: 1) большое кол-во разных фичей. Само по себе некритичное обстоятельство. 2) неоднозначность и дубли фичей. “слева вверху вертикальная палочка, справа от которой горизонтальная палочка”. Таких вертикальных палочек можно найти много. Само по себе некритичное обстоятельство. 3) проклятие определения. Что такое вертикальная палочка? Палочка с нормалью 0 или 180 градусов? А может лучше диапазоны [-30,+30] и [150,210]. А может [-35,+35]? Можно, конечно, попилить всё пространство на такие диапазоны, но тогда будут классические проблемы: палочка с нормалью 36 - не вертикальная, а 35 - вертикальная. Почему? Разницы же не видно. И тут либо придётся всё огрублять с потерей чувствительности (не сможем распознавать разные фигурки), либо вводить несколько градаций, но тогда кол-во фичей возрастает лавинообразно. И что ещё хуже с ростом кол-ва фичей опять проблема: пока не увидим какую-то фичу (палочку в каком-то наклоне) - всё ничего не значем, ничего не умеем.
Такое ощущение, что реальность издевается над тобой. Только ты придумал какое-то решение, а реальность тебе подкидывает примеры, где всё сразу ломается. Смотрел на начертания букв на коробках чай - там вообще пипец. Буквы и так, и сяк написаны. Фичи, выученные для одного способа будут бесполезны для другого.
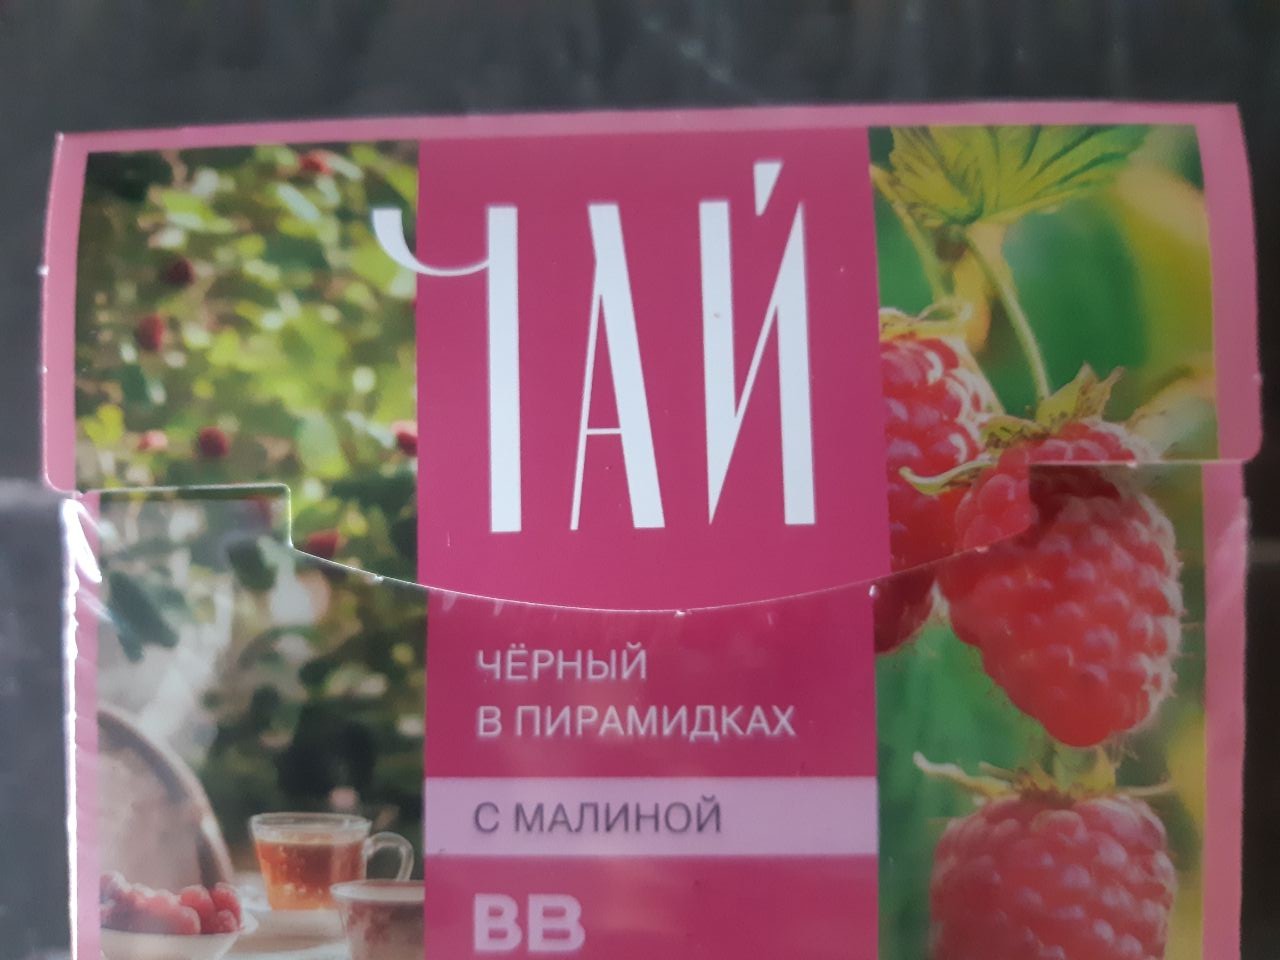
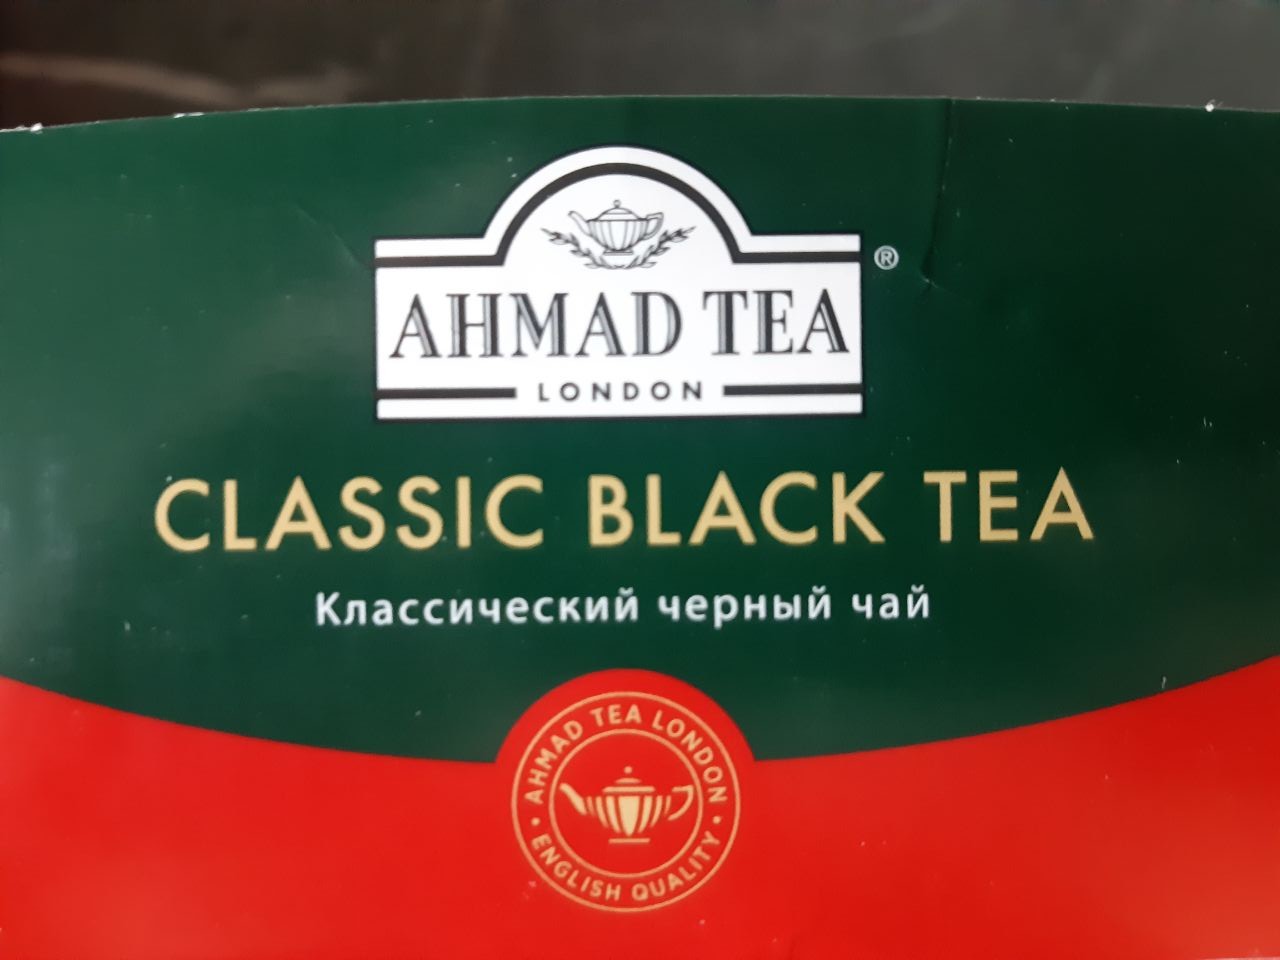
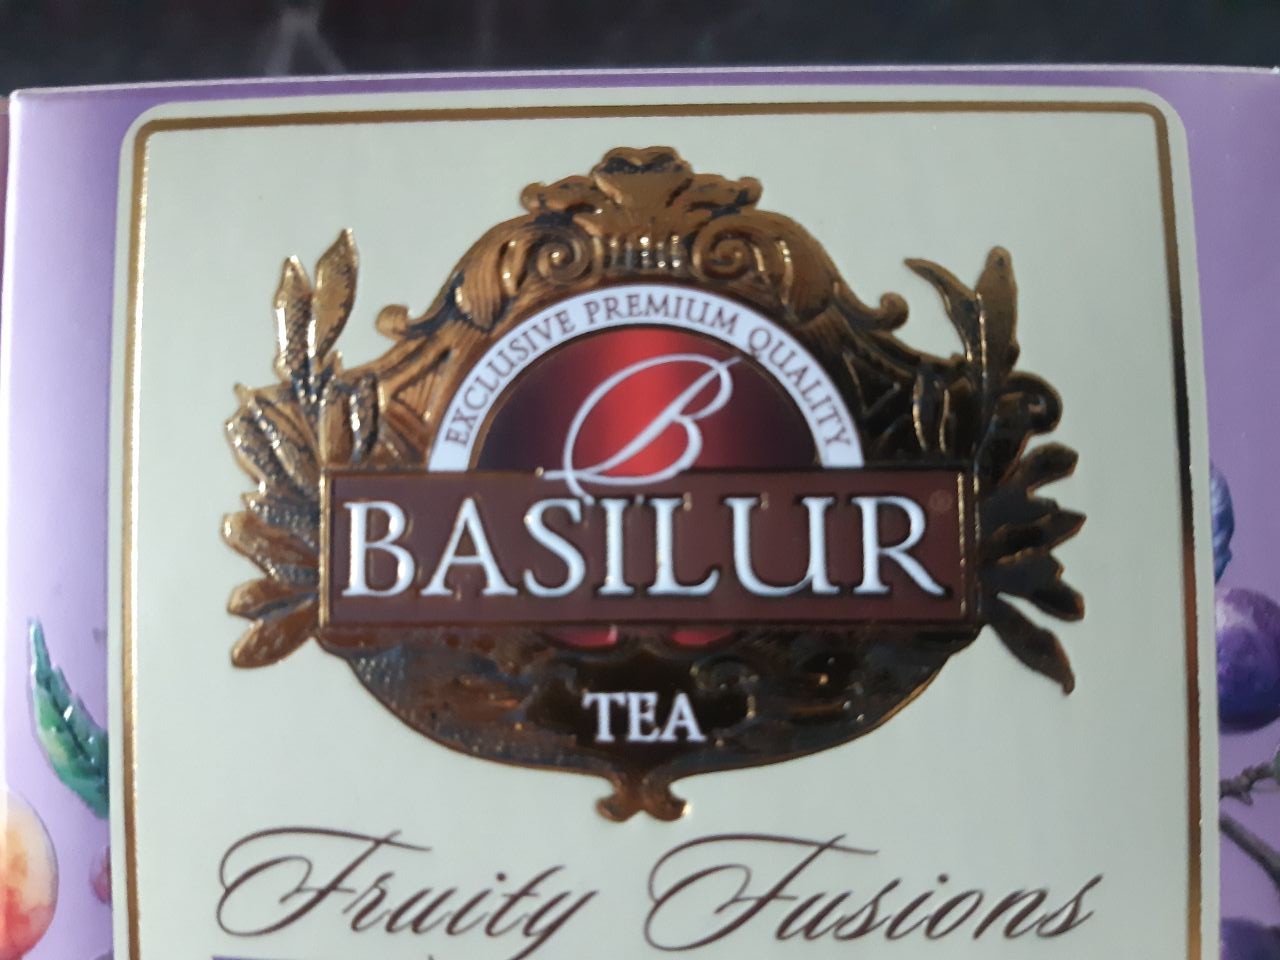
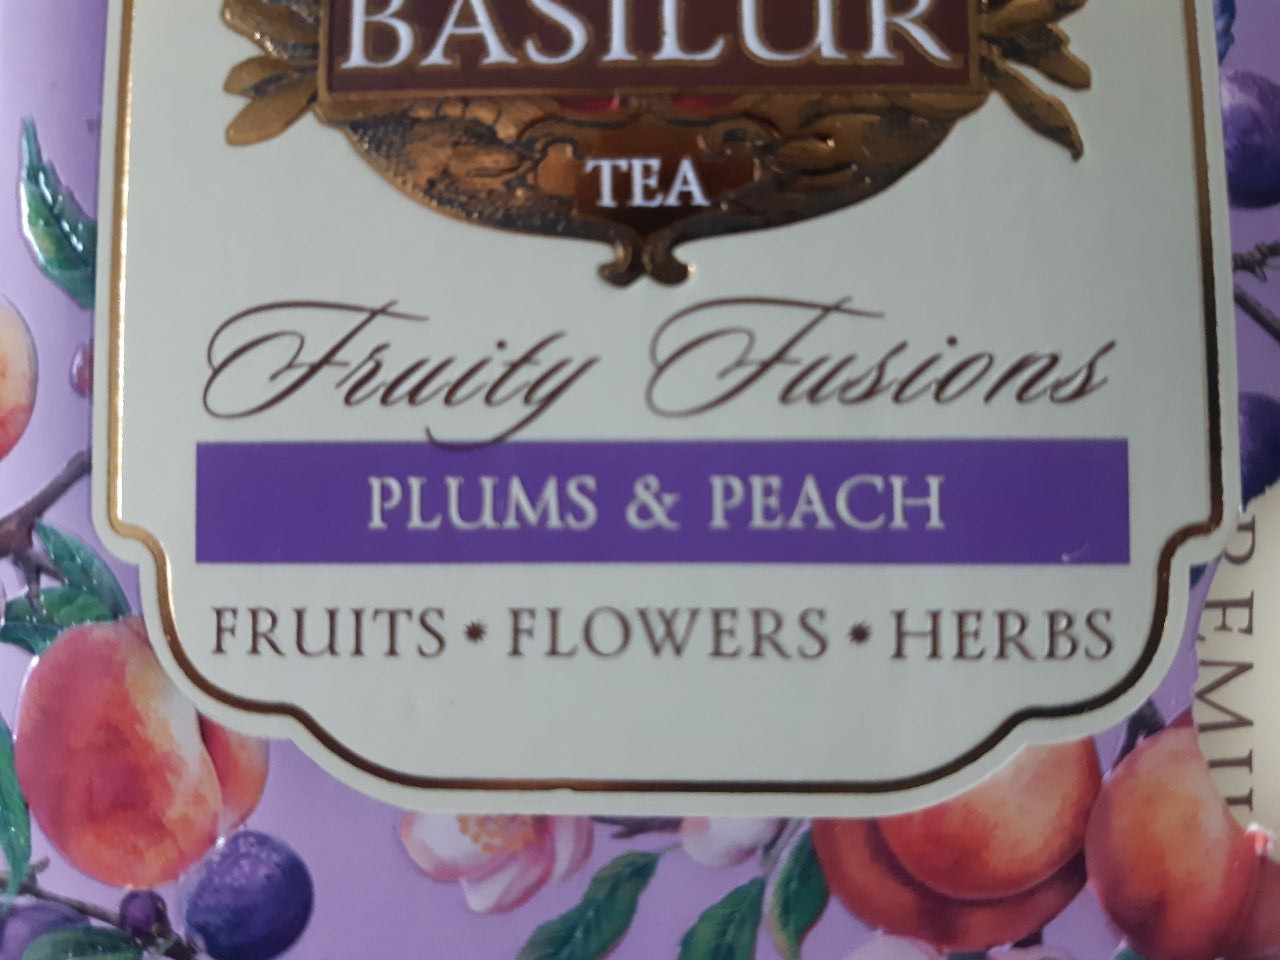
Видно, что тут полная жесть:
- буква “Ч” на вкуссвил чае - пропорции нарушены, длинная нога. Больше похоже на цифру 1
- двойные палки в “Ahmad Tea”
- завитки “Fruity Fusions” или большая буква “B” на Basilur чае.
И при этом наш мозг легко в этом разбирается.
И тут мне пришла в голову мысль, что скорее всего дело в АБСТРАКЦИЯХ. Взять, например, букву А. Если предположить, что в мозгу она описывается следующим образом: “Есть левая нога и правая нога. Они под углом стыкуются в виде домика. Есть перекладинка между ногами посередение”, то тогда левой ногой может быть всё что угодно: прямая линия, штрих-пунктирная линия, завитушечная линия, набор кирпичей, палочка/веточка, рябь на воде, птицы выстроились в ряд и т.д. Т.е. переход от описания фигурк в виде линий к описанию в виде ног (или чего-то более абстрактного) сразу даёт кучу свободы и как будто снимает оковы.
Получается, что есть какие-то роли, и что-то эти роли может исполнять. Роль левой ноги или перекладинки. Сразу всплывает связь с теорией фреймов [MMinskyFrmwrkReprKnowldg], где нужно заполнить терминали конкретными значениями.
Станвится понятным, почему не получается и не получится сэмплить различные образы фигурок из МНР. Потому-что процесс сэмплинга многоступенчатый. Сначала решаем сэмплить цифру пять, потом определяем, кто будет играть роль ковша, кто будет играть роль стойки, кто - крышки. И только потом уже можно сэмплить.
Получается, что наш мозг автоматически и непринужденно познаёт реальность в виде всё более увеличивающихся абстракций. И когда мы коммуницируем друг с другом (голосом ли, письмем ли), то мы сэмплим конкретные артефакты по цепочке абстракций, а на другом конце принимающий должен сделать обратное. И так как оба знакомы с этими абстракциями, то коммуникация получается. А компьютер приходит, и у него нет знаний об этих абстракциях. Даже заставить его понимать, что такое “линия” - уже проблема.
Выводы: 1) чтобы разработать по-настоящему интеллектуальную дискриминацию цифр (которая потом бы легко расширялась на буквы/иероглифы и т.д.) нужно решить задачу абстрагирования 2) формула мозга: суперкондишнинг + символизм + абстрагирование