69) обучение через denoising
После пробежки пришли идеи, как получить систему распознавания MNIST цифр более продвинутой.
Итак, отталкиваемся от эмбеддингов, т.к. это хорошо. Идея №1 - эмбеддинги рождаются от рода деятельности. Система должна решать какую-то задачу, побочным продуктом которой будут эмбеддинги [OlahDLNLPRepr]. В принципе про это же говорится, например, здесь [VincentStackedDenoisingAE] (Training a deep network to directly optimize only the supervised objective of interest (for example the log probability of correct classification) by gradient descent, starting from random initialized parameters, does not work very well).
Т.е. решение задачи “в лоб” - напрямую классифицировать MNIST цифры - это не хорошо. А раз так, то идея №2 - а давайте представим, что мы в агресивной среде, где некий демон портит нам картинки циферок (затирает, замыливает, вырезает и т.д.). Человек же может в этой ситуации справиться. Значит, надо заставить систему научаться в этих условиях. По идее должны возникнуть репрезентации, использование которых в чистой среде позволит легко решить задачу.
Вспомнил, что что-то читал про denoising. Нашёл статью Xie et al. Noising and Denoising Natural Language [XieNoisingDenoisingNL]. В ней про denosing текста. В статье была ссылка на работу [VincentStackedDenoisingAE]. В свою очередь на [VincentStackedDenoisingAE] ссылается уже ЛеКун с его H-JEPA и авторы статьи Assran et al. Self-Supervised Learning from Images with a JEPA [AssranSelfSupervisLearnImages].
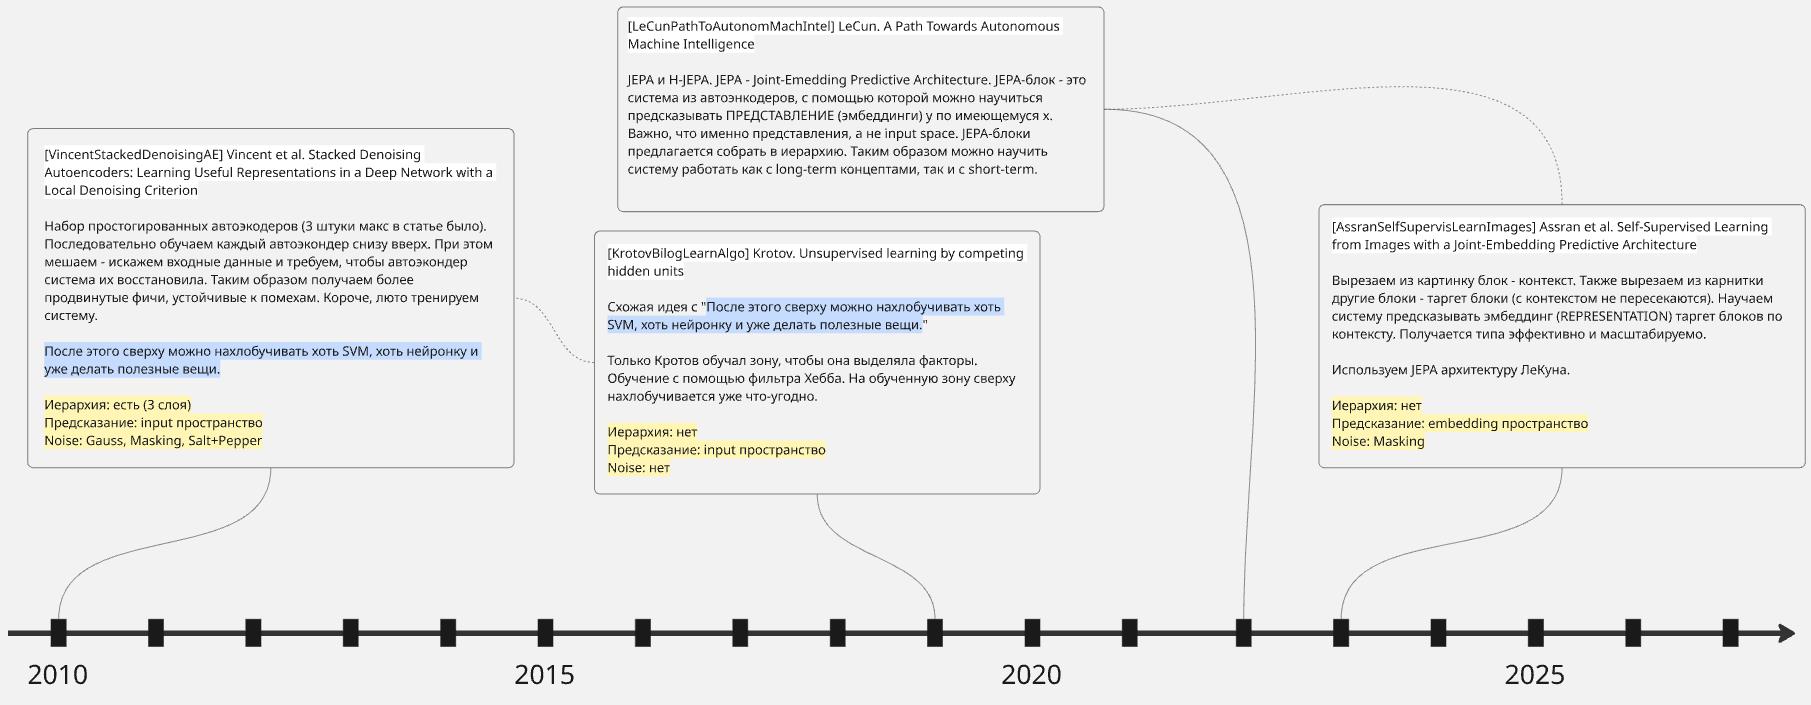
Короче исследовательская мысль развивалась так: 1) давайте простогируем автоэнкодеры и будем их обучать в зашумленных условиях предсказывать input (denoising AE) - 2010 год 3) давайте простогируем автоэкондеры и будем обучать их предсказывать ПРЕДСТАВЛЕНИЯ (H-JEPA) - 2022 год
Пока пункт 2) (идеи ЛеКуна) реализован в 2023 в однослойном варианте (без стога автоэнкодеров) - I-JEPA
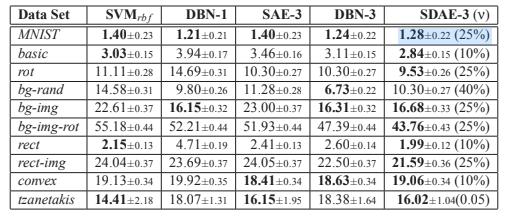
При этом даже пункт 1) из 2010 даёт типа хорошие результаты на MNIST. Можно предположить, что в верхних автоэнкодерах само собой появляются понятия об отдельных цифрах, что влечёт за собой умение системы корректно описывать рапределение пикселей для разных вариантов.
Учитывая, что I-JEPA выглядит слишком ресурсоёмким (For instance, we train a ViT-Huge/14 on ImageNet using 16 A100 GPUs in under 72 hours), хочется поиграться с моделью из 2010.