70) СМЕНА ФОКУСА
До недавнего времени, а именно до заметки 35, я находился под влиянием идей Редозубова из [РдзбЛогСозн], а именно то, что настоящий, биолгический нейрон совсем не похож на то, что используется в искуственных нейронных сетях (ИНС). Например:
> Позже, когда пластичность реальных синапсов стала изучена лучше, оказалось, что в ней мало общего с правилами обучения нейронных сетей. Во-первых, в большинстве случаев изменения в эффективности синаптической передачи бесследно проходят через непродолжительное время. Во-вторых, нет никакой заметной совместности в обучении различных синапсов, то есть ничего, чтобы напоминало совместную нормировку. В-третьих, эффективность передачи меняется под действием поступающих извне сигналов и не очень понятно, как она зависит от реакции самого постсинаптического, то есть принимающего сигнал, нейрона. Добавим к этому, что, кроме всего того, реальные нейроны не работают как линейные или пороговые сумматоры.
Мысль, что биологический нейрон не равен нейрону в ИНС, заставляла отвергать все достижения и впечатляющие результаты тех же трансформеров и проч. Дескать, вы делаете всё неправильно, а вот у нас с Алексеем то истинное знание. Правда - какое оно истинное - вот это вопрос. Да, идеи про волновое распространение информации и метаботропные рецепторы, как хранилища энграмм и как участники фильтра Хебба - всё это выглядит правдоподобно. Но как из этого собрать какой-то рабочий прототип, который бы справлялся хотя бы с той же задачей классификации MNIST - непонятно.
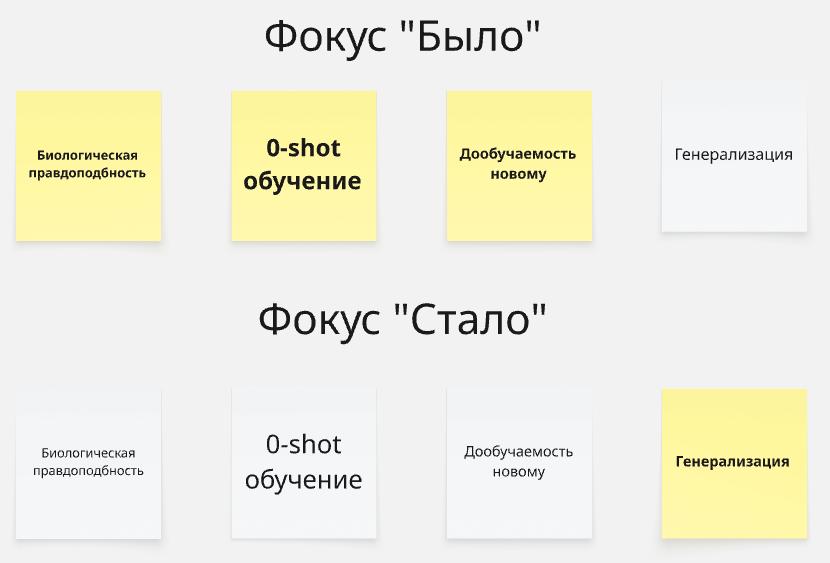
Как следствие отстраивание шло от того, что плохо в ИНС. А именно: 1) проблема с 0-shot обучение, что выражается в том, что нужно очень много примеров, чтобы обучить сеть. В то время как человек типа умеет с первого взгляда запомнить что-то и использовать 2) проблема с дообучемостью (проблема пластичности-стабильности). Вот как сделать так, чтобы ИНС можно было бы научить новому, и чтобы старое не сломалось?
Дескать, если делать так, как в живой ткани устроено, то эти проблемы будут решены. И исподволь я фокусировался на этом, держал постоянно в фоне эти две проблемы: 0-shot обучение и дооубчаемость.
Но вот по прошествии почти года моё мнение поменялось. Да, оно поменялось ещё с августа (заметка 35), но теперь оно обросло дополнительными оттенками.
Мозг строит картину миру с самого рождения. Большую картину. Ещё летом 2024 я думал, что механизмом изучения мира есть предсказание. Изучая литературу вижу, что это всепроникающая мысль. Начиная от Хоккинса, и заканчивая Саттоном, ЛеКуном и Хинтоном. Да может по другому и невозможно. Только наблюдая за миром, за его изменением и взаимодействуя с миром субъект формирует модель мира, познаёт его законы, вырабатывает понятийный аппарт (representations). Так или иначе многие сходятся на том, что это выглядит как иерархический стэк автоэнкодеров (или их эквивалентов, типа JEPA): [LillicrapBackpropBrain], [HintonGlomFinal], [LeCunPathToAutonomMachIntel], [VincentStackedDenoisingAE], [AssranSelfSupervisLearnImages].
Далее, модель мира огромная, а значит и сетка отгромная получается. И вот за счёт размера сетки, а также наличия явно выделенной памяти, и будет обеспечиваться 0-shot обучение и дообучение. Это показывают LLM модели, которые а) имеют знание мира в виде обученных весов, б) имеют память в виду контекста (токены). И в принципе никто не мешает сетке накапливать за какой-то период информацию в контексте, а потом ночью (во сне) её перекладывать в веса. И LLM не нужно переучиваться заново, чтобы понимать информацию в контексте, коль скоро эта информация подкреплена инфой а). Т.е. 0-shot обучения оно просто следствие того, что потреблённая информация известна и для неё есть интерпретация из модели мира. А дообучение - это просто перекладывание из кратковременной памяти (контекста) в веса.
М.б. это грубовато, но по-крайней мере это работает на практике.
Так и с человеком. Человек первые годы жизни интенсивано познаёт мир - строит у себя в мозгу модель. Обретает здравый смысл (анлийское “common sense” лучше передаёт - общий смысл, смысл, которые все другие понимают). И вот когда есть здравый смысл, когда есть запчасти, из которых можно описывать мир, тогда и 0-shot обучение само собой приходит. И дообучение тоже.
Короче, размер имеет значение.
Но что ещё важно, с чем столкнулся - это проклятие размерности. “You’ve seen all the words that you understand before, but you haven’t seen all the sentences that you understand before. So too with neural networks” [OlahDLNLPRepr]. И пока единственным ответом на проклятие размерности есть внутренние представления (эмбеддинги, representations), которыми можно манипулировать. И которые передают структуру мира, отношения между запчастями.
Таким образом, фокус надо сместить. Главное проблемой, имхо, является “генерализация” - способность обобщать, способность работать с out-of-vocabulary элементами. Надо перестать открещиваться от ИНС, а вместо этого взять лучшее, что там наработано. А потом, когда будет результат, уже можно подумать, как это переложить на биолгически-plausiable материал (с теми же метаботропными рецепторами). Но с начала нужен результат.