72) реконструирующий автоэнкодер
Два факта о зрении.
1) чёткость зрения неравномерна. Максимльная чёткость в середине зрачка, а к периферии чёткость круто снижается
2) глаз делает саккады и микросаккады (ещё есть тремор), когда изучает сцену.
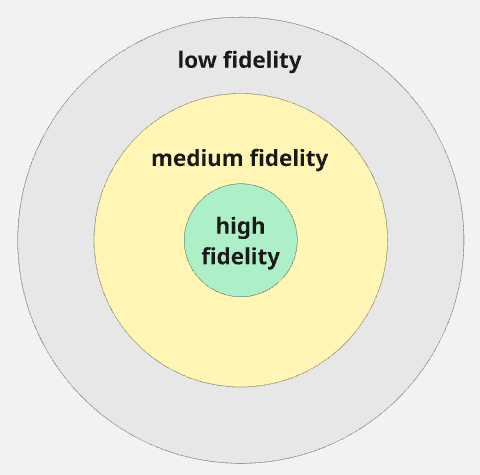
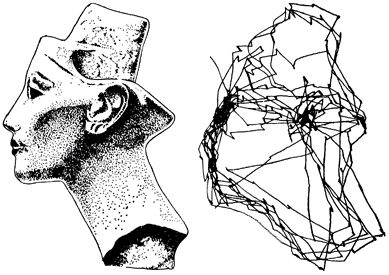
Но известные сети делают одно и то же - рецептивное поле сетки есть всё изображение сразу с одинаковой разрешающей способностью. Если забыть про пункт 1) и хотя бы оставить пункт 2), то становится понятным, что для работы визуального восприятия требуется память для хранения того, что было зафиксировано очередной саккаой. Эти фиксации составляют постоянно растущий контекст. При поступлении новой фиксации и контекста кора может все более точно определять, что она видит. Если недостаточно, то можно сделать новые фиксации, которые дадут ещё информации.
Всё это можно представить следующей схемой.
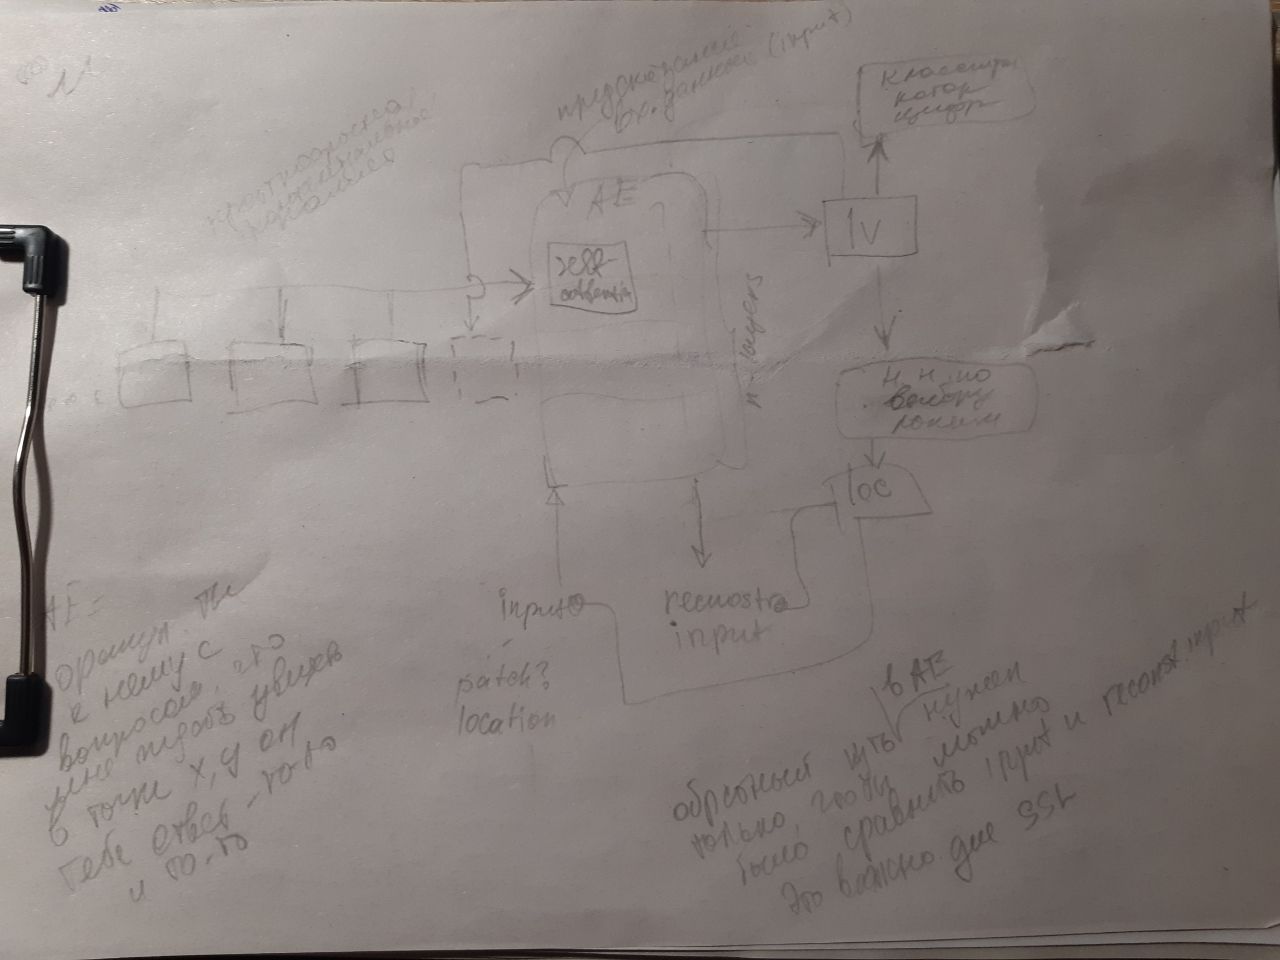
Тренить такую сетку будет долго, т.к. придётся последовательно скармливать по одной фиксации (в краткосрочную память кладуться сформированные эмбеддинги, поэтому за раз несколько фиксаций вроде не получается, либо unroll-ить автоэнкодер придётся).
Поэтому пришёл к идее сделать слеующее: 1) берём картинку цифры 2) выделяем 10-15 точек 3) скармливаем их сетке 4) требуем от сетки восстаноивать недостающее
Т.е. на вход точки - на выходе полностью заполненная фигура. Что-то типа reconstruction - реконструирующий автоэнкодер.
В идеале потом сетка должна уметь восстанавливать не только из равномерных точек, но, например, по верхней части цифры её нижнюю часть и т.д.
Заодно можно поупражнятья с pytorch.