73) positional encoding
Т.к. в заметке 72 был поднят вопрос о наличии self-attention, то в памяти всплыл момент с positional encoding, применяемый в трансформерах. В [VaswaniAttentionIsAllYNeed] используются синусоиды разных частот, которые добавляются к ебмеддинг вектору. Формульно это было понятно, но вот интуитивного понимания почему так делается не было выработно.
Прокопал эту тему и теперь боль мень понятно стало. Значит, основной момент - это то, что при attention мы по сути делаем скалярное произведение векторов в контексте друг с другом.
https://www.reddit.com/r/MachineLearning/comments/cttefo/comment/exs7d08/ > In attention, we basically take two word embeddings (x and y), pass one through a Query transformation matrix (Q) and the second through a Key transformation matrix (K), and compare how similar the resulting query and key vectors are by their dot product. So, basically, we want the dot product between Qx and Ky, which we write as: > > (Qx)’(Ky) = x’ (Q’Ky). So equivalently we just need to learn one joint Query-Key transformation (Q’K) that transform the secondary inputs y into a new space in which we can compare x.
Естественным образом ожидается, что токены, которые находятся на близких позициях должны иметь более высокое значение dot product. И при этом ключевой момент: мериться должны относительные позиции. Т.е. токены на позиции 5 и 6 должны иметь вклад в dot product такой же, как из токены на 100 и 101 позиции.
А теперь эксперимент. Делаем кодирование позиции в лоб: np.arange(100) и делаем кодирование позиции через синусоиды (см. positional_embedding.ipynb):
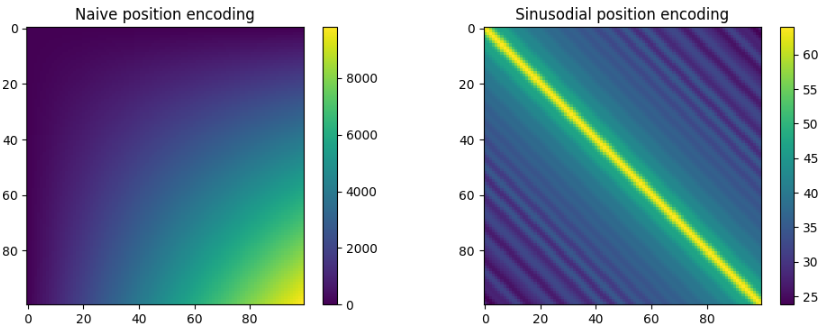
Ну, короче, видно, что наивное кодирование не совместимо с dot product. По факту мы имеем абсолютное кодирование, что приводит к тому, что dot product для токенов на позиции 5 и 6 на порядки отличается для токенов в позиции 80 и 81. Тогда как синусоидальное боль-мень выдерживает нужное свойство: токены на позициях недалеко друг от друга имеют более высокий dot product, и с ростом расстояния dot product уменьшается.
Становится, понятным, что могут быть изобретены и другие схемы позиционального кодирования. Например, Rotary Positional Encodings и другие. Но главное, суть!
Возвращаясь к https://www.reddit.com/r/MachineLearning/comments/cttefo/comment/exs7d08/, тут ещё и объясняется, почему мы не конкатенируем, а именно добавляем position encoding.
> If true, this would explain why adding positional encodings, instead of concatenation, is essentially fine. Concatenation would ensure that the positional dimensions are orthogonal to the word dimensions, but my guess is that, because these embedding spaces are so high dimensional, you can get approximate orthogonality for free even when adding, without the costs of concatenation (many more parameters to learn). Adding layers would only help with this, by allowing for nonlinearities.
Полезные источники: