80) руда и пластичность
Читал [FieldNatImsStats]. С трудом продирался через текст, т.к. текст предполагал продвинутое знание и практические навыки по digital signal processing, особенно в части Фурье/вейвлет преобразований. И вот в очередной раз осмысляя одно из предложений, кажется уловил, что происходит в мозгу в этот момент.
По сути продираясь через текст мозг на постоянной основе крутит/вертит/мнёт/деформирует текущую модель (текущий state?), с тем чтобы пройдя вниз по top-down связям эта модель срендерила с нужной точностью то, что сейчас воспринимается и подается по bottom-up связям. Т.е. понимание, это на 50% (а то и больше) процесс мутирования внутренней модели. Это генеративный процесс.
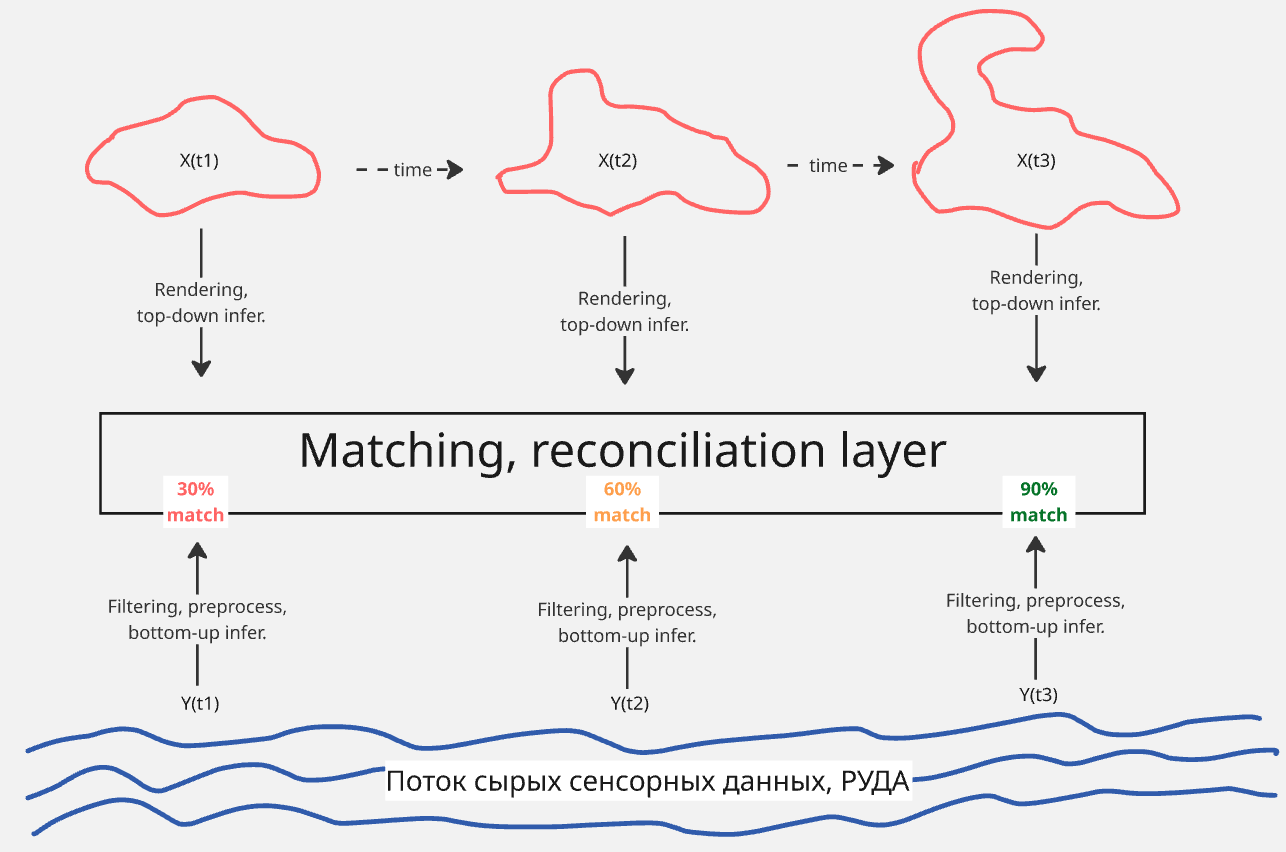
Да, в этом можно усмотреть формулировку Байесовского подхода, который хорошо сформулирован в [MumfordNeurArc]:
> assume that $X$ is a set of variables describing the world - called the hidden variables - and that $Y$ is the data we observe. We assume, moreover, that from experience we know the “prior” probability $pr(X=x)$ that the variables $X$ take on every possible set of values $x$ (e.g. you know it is very likely that your grandmother is wearing a bikini), and that we also know the conditional probability of very possible observation $y$ given the state of the world $x$, written $pr(Y=y|X=x)$. Then if we have observations $y$, we will want to estimate the most likely a posteriory values $x$ of the hidden variables describing the world. Bayes says to do this by finding the $x$ that makes the conditional probabilty $pr(Y=y|X=x)$ the largest, whcy by Bayes’s theorem is the $x$ that maximizes $pr(y|x) \cdot pr(x)$. So if we think we Granny in a bikini at a great distance, we reject the conclusion, but if we see her to attired close up, we have to accept it as fact.
Так вот. Получается, что $X$ - это и есть наше внутренее знание, наше внутренне состояние или hidden variables. А $Y$ - это то, что мы выгребаем из сенсорного потока. Просто казалось, что $X$ - это где-то далеко, непонятно где, в Платоновском эдеме. А на самом деле - это $X$ внутри нас. И пытаясь что-то понять, мы вынуждены это $X$ мутировать! Только происходит это само собой, а мы либо получаем сигнал bingo!, либо чувствуем, что только потеряли время.
Но тут фокус на то, что крутить тумблеры надо у $X$. Это как бы система с гальванической развязкой. Или как тумблеры на радиоприёмниках - ты их крутишь, и если попал в частоту, то слышишь радиопередачу.
Безусловно, вся эта схема напоминает автоэнкодер.
Чтобы интуитивно почувствовать, можно обратиться к примеру из [СтивенсPyTorch], где есть мысленный эксперимент по embedding (разложить понятия в пространстве).
Возможны несколько вариантов при чтении книги: 1) переменные $X$ настолько отточены и inference настолько гладко идёт, что никакого мутирования не требуется, ну или совсем минорные коррекции. Это состояние НЕИНТЕРЕСНО, СКУЧНО 2) как ни крути $X$ не получается хороший reconciliation получить (т.е. не получается срендерить $\hat{Y}$, так чтобы соответствовал наблюдаемому $Y$). Это состояние, когда вроде каждое слово понимаешь по отдельности, а всё вместе - какая-то каша. Не взлетает пепелац и всё тут. Это как у меня было при чтении [FieldNatImsStats]. Только энергия тратится. Это состояние, когда хочется назвать текст БЕСМЫСЛИЦЕЙ или БРЕДОМ. 3) удаётся мутировать $X$, так чтобы формировалось понимание (смысл) считываемого текста (возможно и не с первого раза). Т.е. прочитал кусочек, задумался, мутировал $X$ так, сяк, наперекосяк, потом такой - а да, точно bingo, едем дальше. Вот тут удовольствие получаешь, т.к. чувствуешь, что-то впитал новое. Это то состояние, которое у Оруэлла в 1984 “Лучшая книга говорит тебе то, что ты и так знал” (я долго не мог решить противоречие: если ты это знаешь, то какое в этом удовольствие, а если не знаешь, то и не поймёшь. А вот оказывается, что это просто должна быть ещё операция мутирования $X(t+1) = mutate(X(t))$, в которой $X(t)$ должно быть известно - см. заметку bc.17).
Да и вообще походу описанный подход - он не только при чтении, но везде применяется. При общении, при моторных действиях и т.д.
Собственно понятно, почему когда второй раз книгу перечитываешь, можешь уже другой пласт смыслов извлечь. Потому что к моменту старта чтения модель уже не такая плоская и примитивная. И следовательно, можешь уже лучше предсказывать/предвосхищать входящий поток.
В каком-то смысле это расширение/уточнение идей из заметки 62.