85) #76 -> stacked DAE 3-layer (launchit)
Ноут s3_stacked_dae_07.ipynb.
> 8) важно уметь конструировать МАШИНЫ СИСТЕМНОГО ПОИСКА оптимального сочетания параметров. Этим и надо заняться. А то с SVM как-то тяжко получется - слишком много переключений.
В первом приближении автоматизировал наиболее трудоёмкие этапы. Получилась система: 1) через launchit создаёшь новый запуск 2) в ноутбуке для запуска указывает гиперпараметры 3) запускаешь (можно в параллель несколько ноутов) 4) в рамках одного ноута создаётся pretrain модель и потом поверх неё файн-тюнится уже модель логистической регрессии.
Лучший результат test accuracy = 98.9% (или 110 ошибок на 10000 примеров).
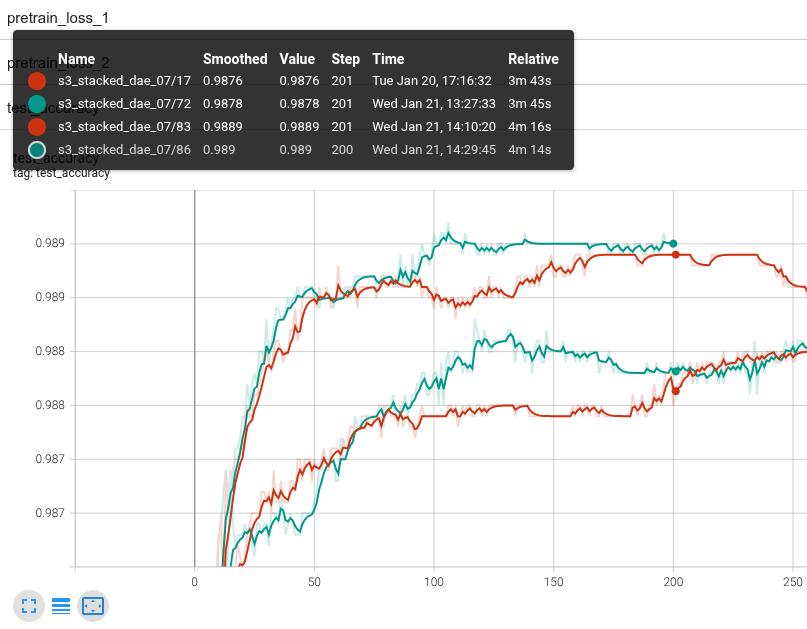
Блин. Сразу же есть результат! До автоматизации очень сложно понимать результат и что его произвело. Особенно когда свистелок и перделок, которые можно крутить, огромное кол-во. А здесь на системной основе делаешь запуски, настраиваешь параметры, смотрешь ИТОГОВЫЙ результат! И главное понятно, от чего он зависит. Поэтому можно целенаправленно углубляться в какие-то области гиперпараметров.
Таким образом, например, выяснилось: 1) ЧТО ХОРОШО СРАБОТАЛО:
- learning rate для Adam для файн-тюнинга должен быть 0.001 или около этого
- явное управление random_seed. От этого test_accuracy порой сильно зависит
- возможно выбрать preatrain_model из наиболее удачных. Таковой оказалсь, например, 17 версия
2) ЧТО НЕ СРАБОТАЛО:
- попытка без nonlinearity в StackedDAE. Отдельно игрался для экондера, декодера. Нифига. Для BCELoss вообще без сигмоиды нельзя, т.к. BCELoss ожидает, что target находится в диапазоне [0,1]
- включение/выключение bias в StackedDAE
- регуляризация для активаций (фича детекторов). Не помогла. Вспоминая
[HintonDropout]- там написано, что Dropoup (как развитие идей деноизинга) и так является сам по себе сильной регуляризацией. Поэтому видимо и нет эффекта - попытка MSELoss + регуляризации. Не получилось. В какой-то момент хотелось получить результат, как в[OlshausenSparseWithOvercompl], то бросил это дело. Фильтры никак не хотели формироваться как надо. Видимо какая-то более хитрая регуляризация нужна что-ли, чтобы заменить логику из[OlshausenSparseWithOvercompl]3) НА ЗАМЕТКУ:- модели 17, 72, 83, 86 на supervised этапе имеют accuracy равную 1 и потери около 0. Неудивительно, что им не получается преодолеть барьер 98.8% - система просто не понимает куда двигаться с таким низким loss
- Dropout как развитие идеи denoising очень заманчиво выглядит