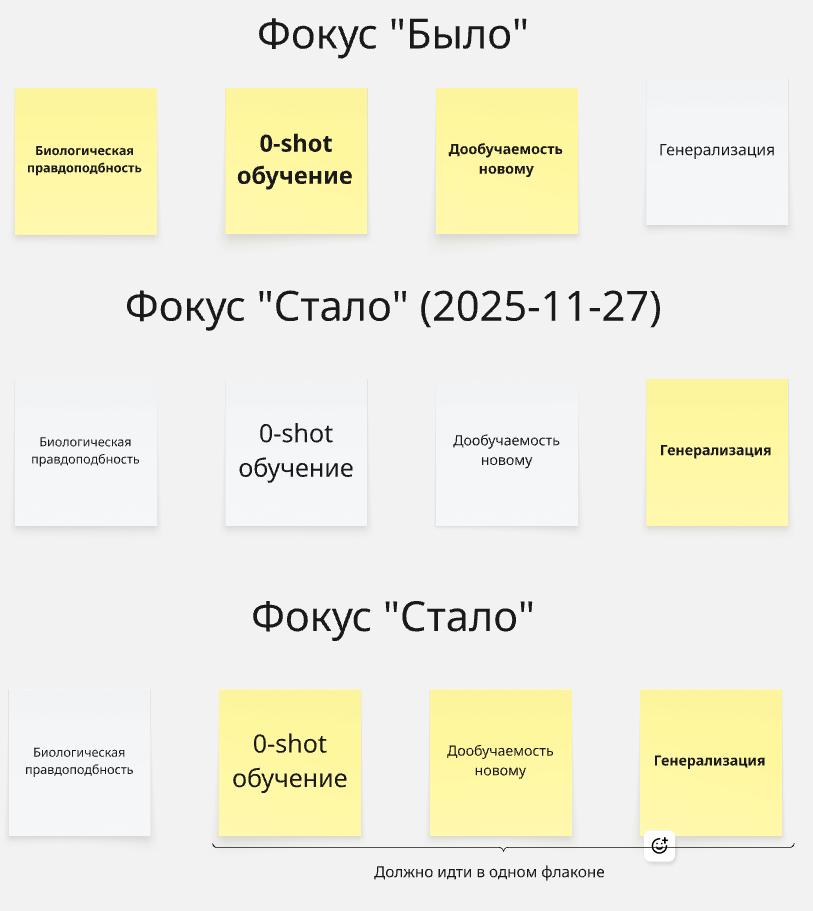
90) ревизия подходов 2 и коррекция плана
Продолжение №24 и №76.
Подход 1. Naive
Идея, что можно иметь набор ядер метчинга, достаточный для распознавания любой фигуры. В том числе была идея, что некоторые ядра будут целиком фигуру познавать, а другие отдельные части. Этакие точки зрения. Элементы эволюционного программирования и попытка из рандомных элементов “вырастить” хорошо работающий набор.
Забавно, что набор ядер напоминает DFT/DCT/… Т.е. описание фигуры в виде суммы более простых элементов
Подход 2. HDC
Вдохновление от HDC.
Модель сетчатки с дальнейшим представление фигур в виде HD векторов. HD вектор описывает набор нормалей контура фигуры. Далее используем запоминание примеров с метчингом через COSSIM / Хэмминга.
Игры с идеями елозинга и распространения поля (контурные поля).
Bundle и debundle. Первый - рабочая вещь. В какой-то мере напоминает PCA. Вторая - нет, как потом оказалось debundle приводит к тому, что начинуют выучиываться вещи, которые отсутствуют в фигуре.
Attempts to get no mistakes. Тоже хорошо работает.
В итоге 95% accuracy. Но! Система не умеет понимать, где новая информация, а где известная (т.е. infer rate = 100). Последние 5% требуют непропорционально большего числа примеров для запоминания. Т.е. неважное обобщение
Подход 3. Sequencing
3a. Внешние контуры
Секвенсинг внешних контуров. Каждый внешний контур суть кольцо с ориентацией против часовой стрелки. Временный отход от HDC, т.к. последние невозможно интерпретировать. Захотелось иметь интерпретируемый материал. Так что обычные вектора.
Понятие seq_lv и hook. Вся фигура описывается набором секвов. Каждый секв представляется латетнтным вектором seq_lv фиксированной длины (происходит растяжка/сжатие секва). Точками входа в seq_lv являются короткие отрезки секва (hooks). Через hook находим seq_lv и далее cos_sim или sum diff.
95% точности достигается. Но проблемы с разоварнными фигурами (например, 8 в разрывом вверху). Опять же ничего не остаётся, только как запомнить все такие образцы. Также проблемы с тем, как соотносить разные контуры. Например, в 8-ке их обычно 3: один внешний и два внутренних. Всё таки важно их относительное распрложение.
Тем не менее результат был лучше, чем в голом HDC, который HDC по факту работал с растровым материалом.
3б. Внутренние контуры
Секвенсинг внутренних контуров, который должен был решить проблемы с а) разрывами, б) относительным расположением секвов друг с другом, в) закладывал бы базу для случаев, когда, фигура частично представлено. Неожиданно много проблем даже с их распознаванием. А потом как их комбинировать и в какой ориентации? Комбинаторный подход, когда оперируем сразу всеми возможными комбинациями. Но для 5-секва их уже 3840!
Разные подходы: натяжка (интерпретация), diff sq, корреляция, cos sim, cos_sim + PCA. Лучший результат cos_sim+PCA 92/93%. Не дотягивает до варианта с внешними секвами. Плюс очень много запомненных примеров - плохая обобщающая способность.
Подход 5. Transforms
Пленение идеей, что можно заиметь набор трансформаций и тогда любая картинка есть трансформированный оригинал. Тогда остаётся только выучить обратные трансформации и собрать это всё в кластер (машину) и вуа-ля: подаётся образ и далее в какой-то из трансформаций мы узнаем оригнальный образ.
Выучивание трансформаций в unsupervised режиме из SBV (sparsed binary vector) пар: оригинал-трансформированный оригинал.
Тут был большой прорыв с т.з. познания CUDA и написания кастомных ядер для CUDA.
Но с т.з. сути выяснилось, что проблема фенотипичности не решается. Т.е. невозможно иметь набор трансформаций, который бы объяснил всю фенотипичность образов.
Подход 6. Bayesian
Идея, что есть некоторые модели, которые генерят образы. Т.е. этакий обратный ход. Байесовский анализ, который позволяет по данным провести статистический вывод и найти параметры таких моделей.
Самое главное, что байесовский подход соответствует умению человеков в zero-shot learning. Один раз увидел и готово. Это достигается за счёт априорных знаний. В байесовском анализе априорные знания в саму формулу заложены. Поэтому можно дале линейную регрессию по одной точке построить.
Проработал книгу “Байесовский анализ на Python”, PyMC. Но проблемы встала, что требуется вручную модель определяеть. Есть ли какая-то машина? Машина, которая бы сама модель определяла? Непонятно.
Подход 7. Gauss
Как ответвление от байесовского анализа проработал вопрос Гауссовских процессов. Поразило, что они умеют нативно заполнять пропуски и интерполировать. Причём чем больше данных, тем точнее интерполяция.
Потом некоторые игрищи с MVN. Игра с растрами и может ли MVN сэмплить картинки в виде цифер. Это всё про superconditioning было.
В целом интересная вещь. Даже просматривался механизм exploration, когда система понимала на что нужно обращать внимание.
Но проблема оказалось в том, что это плохо масштабируется. Размерность вектора ограничена где-то 100. Дальше уже пипец начинается.
Ну и проблема в том, что MVN работает на попарных корреляциях, линейных. Сложные закономерности не подхатывает.
Подход 8. Triadic
Очередной возврат к TriadicMemory, точнее к алгоритму DeepTemporalMemory. Хотелось узнать, как у него с т.з. обобщения на примере изучения текстов.
Выяснилось, что никак. По-прежнему требуется изучить примеры, чтобы корректно предсказывать.
Получается, что истинную структуру данных алгоритм DeepTemporalMemory не познаёт.
Подход 9. Sparsenet
Представление картинок в виде overcomplete базиса. Используется регуляризация, чтобы кодировка была sparse.
Проблема basis pursuit.
Пришлось портировать несколько библиотек и разрабатывать модуль для питона, чтобы С-шшный код дёргать, который conjugate gradient descent делает.
Подход 10. Denoise
Проверка идей из [VincentStackedDenoisingAE].
Стогированный автоэкондер, который умеет исправлять картинку. Используем разные виды порчения: гауссовский шум, маскинг, соль и перец.
98.79% test accuracy на MNIST.
Прокачка знаний в PyTorch.
Уточнённый план по сравнению с 76. Отказываемся от reconstr AE и AE на базе self-attention. Глобально надо двигаться в сторону ГЕНЕРАТИВНЫХ моделей. В промежутке попробуем CNN из [JarretBestMultiStageArc] по следующим причинам:
1) самый высокий test_accuracy > 99%
2) CNN - хочется и надо попробовать
3) техники subtractive and divisive normalization - хочется пощупать
4) подветрдить значимость recficiation layer (RelU)
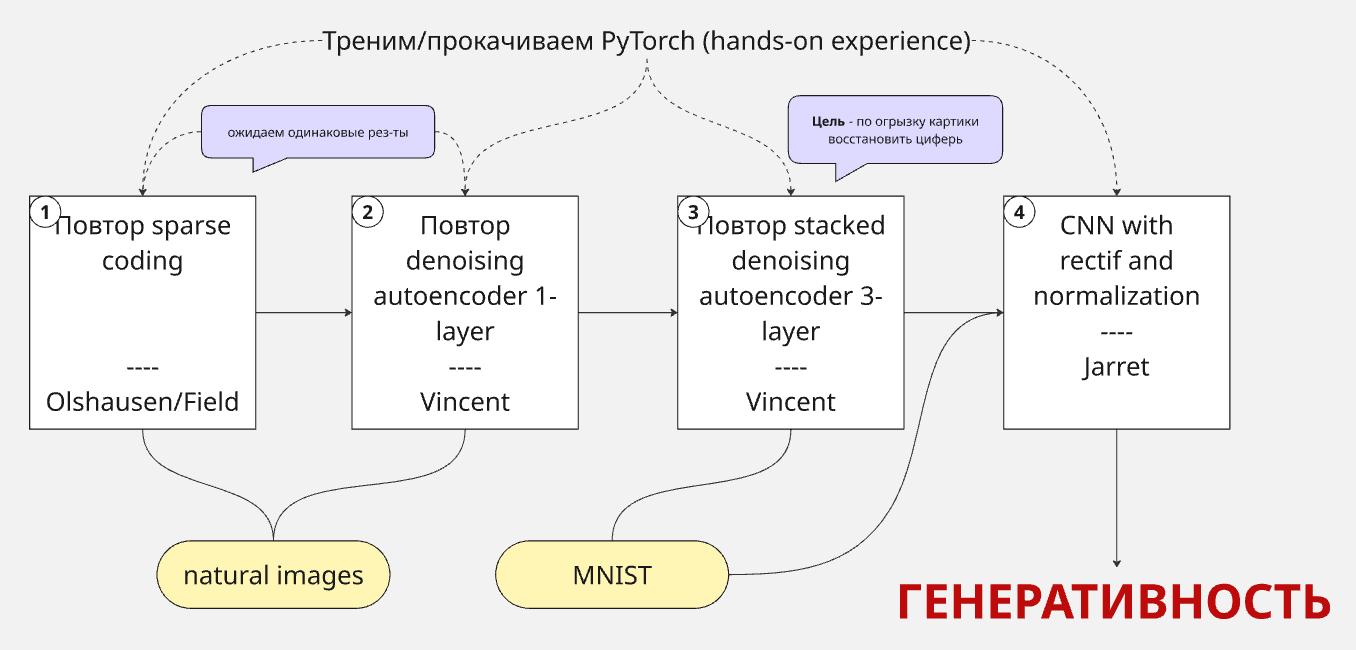
Также уточнённые фокусы