91) #90 -> CNN+PSD, 99.49% test accuracy!
АРХИТЕКТУРА
Ноуты s4_cnn_02 + s4_psd_01. Композитная модель:
- s4_psd_01 с поощью алгоритма Predictive Sparse Decomposition ищет оптимальные ядра свёртки - pretraining
[JarretBestMultiStageArc],[KavukcuogluFastInferSparse] - s4_cnn_02 - два слоя свертки + feedforward сеть для классификации. Также используется rectification (abs), local contrast normalization и average pooling.
Забегая вперёд надо сказать, что ядра свёртки, подготовленные s4_psd_01, не пригодились. Проще в s4_cnn_02 с нуля их натренить. Но это а) на MNIST б) я ограничился только первым свёрточным слоем. Возможно, если бы сделать претрейнинг двух свёрточных слоёв, то было бы лучше. Ну вообще смысл был в том, что с претрейнингом типа быстрее основная сетка учиться. Но тут незаметно, т.к. за 100 эпох можно с нуля просто затренить.
РЕЗУЛЬТАТЫ
Короче, так или иначе получились следующие результаты распознавания рукописных цифр (лучшая модель s4_cnn_02:135):
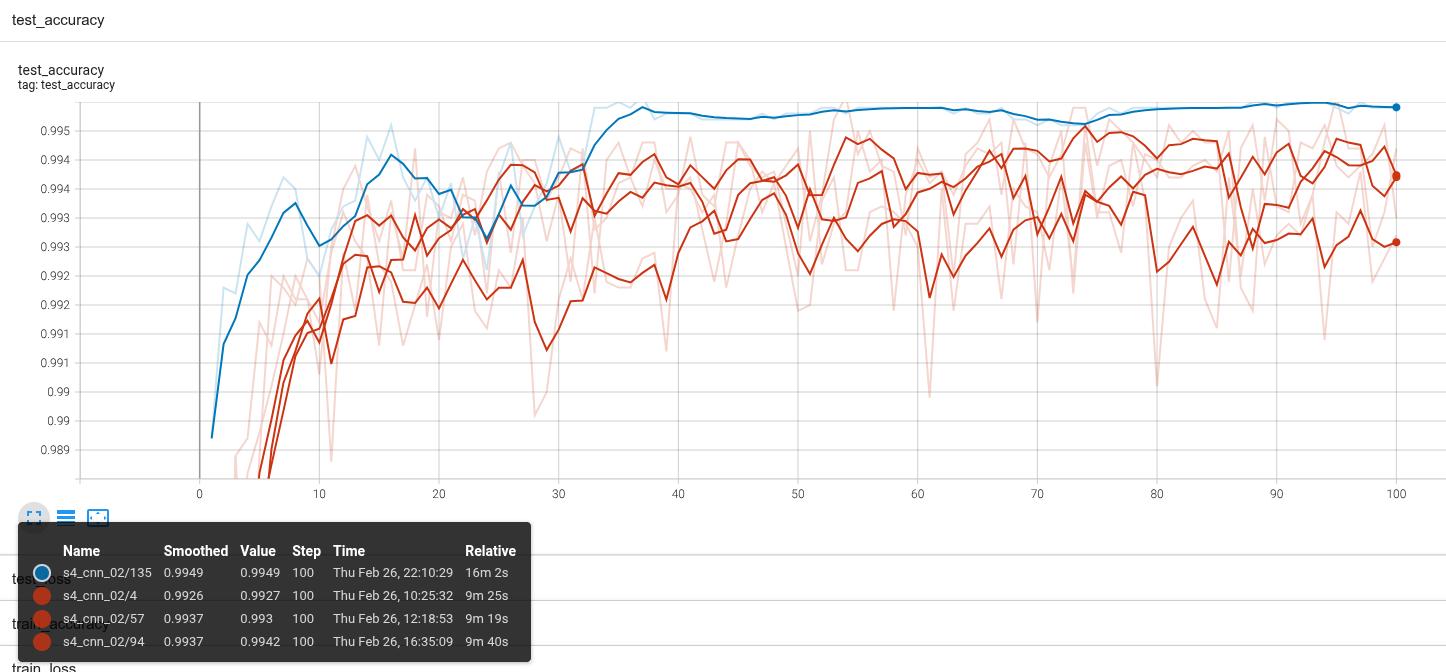
Accuracy 99.49% или test error rate 0.51%. Что бьёться с тем, что заявлено в статье [JarretBestMultiStageArc]: “A test error rate of 0.53% was obtained. To our knowledge, this is the best error rate ever reported on the original MNIST dataset, without distortions or preprocessing.”
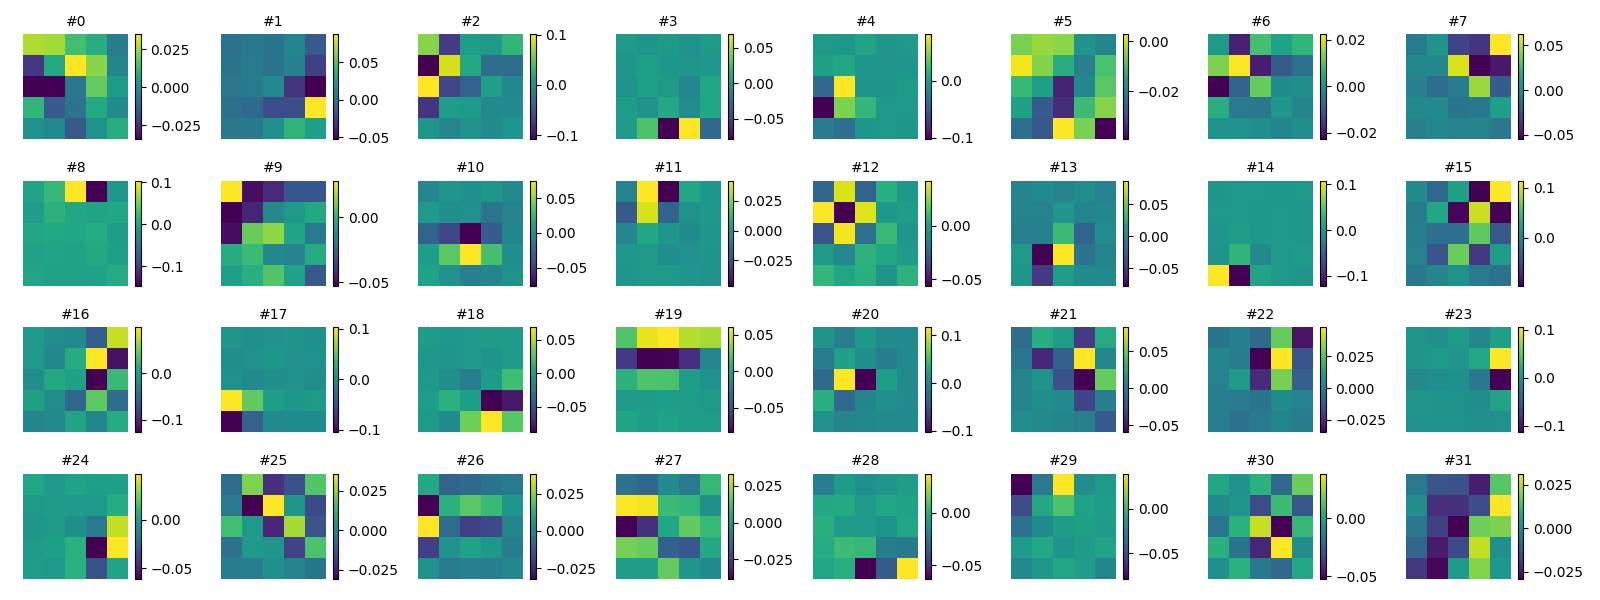
Результаты претрейнинга PSD (лучшая модель s4_psd_01:450):
1) ЯДРА СВЁРТКИ (ЭНКОДЕР)
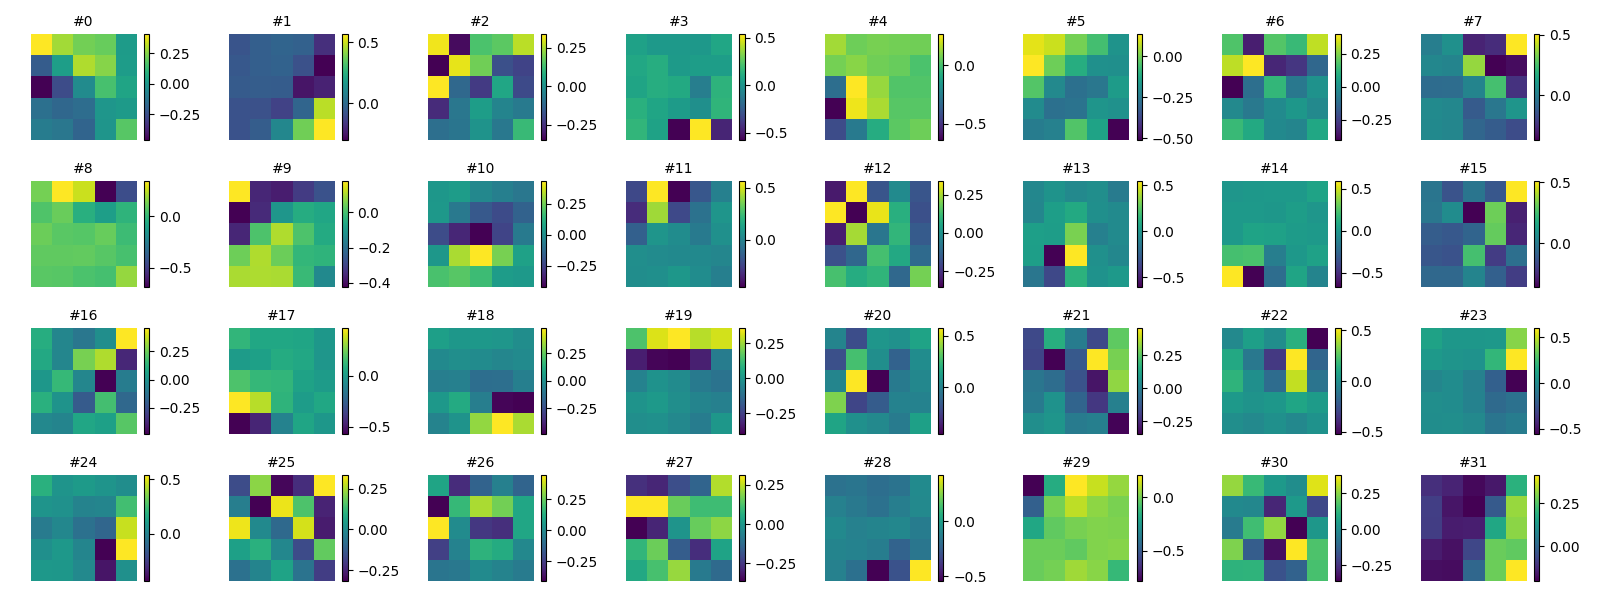
2) АЛФАВИТ (ДЕКОДЕР)
3) ПРИМЕР ВОССТАНОВЛЕНИЯ И ПРЕДСКАЗАНИЯ
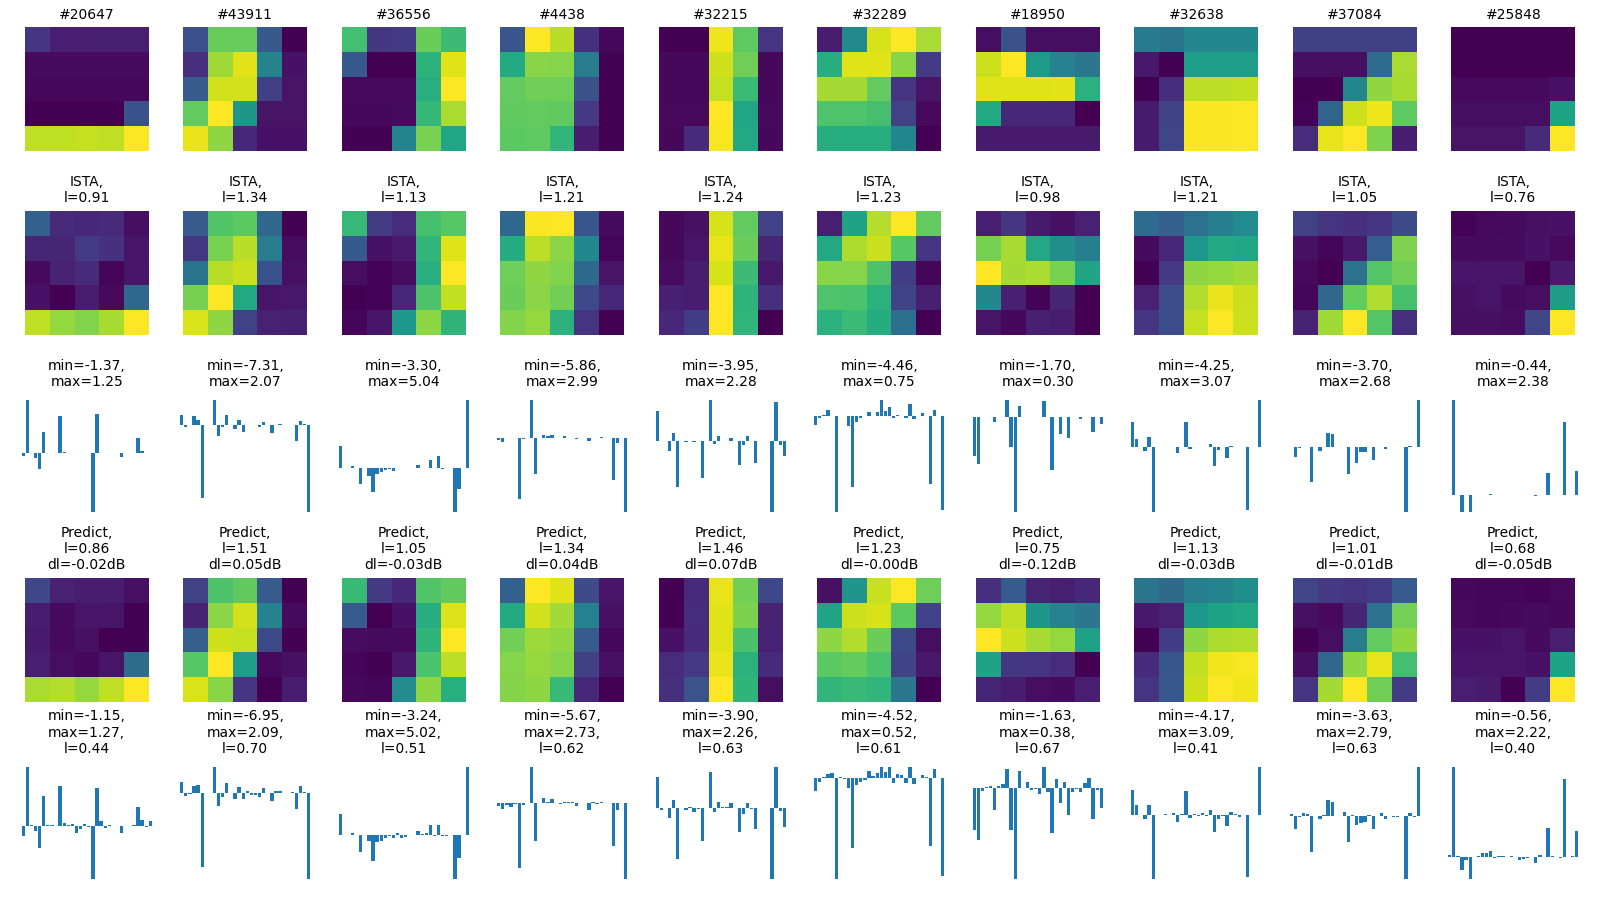
Видно, что ядра похожи на элементы словаря (алфавит), но есть минорные различия. Вообще при претрейнинге мы де-факто имеем автоэнкодер: ядра - энкодер, алфавит - декодер. И часто у автоэнкодера стоит tied_weights=True. Здесь же наглядно видно, что ядра хотят сойтись с алфавитом.
НАХОДКИ ТЕХНИЧЕСКИЕ
Сложные модели проще разбить на несколько и наладить обмен артефактами через model_registry. Тут две модели: PSD и CNN. Сначала думал всё в один ноут запихать, но удачно этого НЕ сделал, т.к. кода в PSD тоже выше крыши. Да и плюс понимаемость и управляемость кодом сразу бы снизилась - был бы огромный, преогромный ноут.
В гиперпараметрах удобность использовать локальный DSL. Например, для описания архиткетуры сетки, для описания скорости обучения и т.д. LARK позволяет быстро описывать DSL и это снижает кол-во параметров в Hyperparameters и при этом сохраняется гибкость. Например, вот так можно:
HP.fe_model_units = [
    'conv(1->32(1)x5+bias)->tanh->gain->abs->avg(2); from:s4_psd_01,450',
    'conv(32->64(16)x5+bias)->tanh->gain->abs->avg(2)'
]
HP.lr_model_units = [
    '200->tanh',
    '10->tanh',
]
HP.learn_rate = '0.0005, plateau(factor=0.5, patience=5)'
Долго сражался с тем, что экондер в PSD (маппинг с последующей нелинейностью и гейном) никак не хотел сходится с тем, что предсказывает декодер (алфавит + алгоритм ISTA). Через пень колоду получил визуально устраивающий результат, подключаю в s4_cnn_02 и получается полный шлак. Потом уже обратил внимание, что гейн веса какие-то огромные - больше 30. Также стало понятно, почему ISTA тоже возвращало какие-то гинантские веса, типа 250. Оказалось, что всё время тренил PSD на ненормализованных патчах, где были тупо значения пикселей от 0 до 255. После нормализации сразу всё встало на свои места!
Для кросс-валидации можно меньше эпох: 15-20. Дальше уже выбрать наиболее многообещающий.
НАХОДКИ КОНЦЕПТУАЛЬНЫЕ
Разрабатывая модель в рамках s4_psd_01, сам собой получился автоэнкодер. Здесь W - это декодер, K - энкодер. W используется алгоритмом ISTA для решения проблемы basis pursuit. Т.е. W - это часть генеративной системы: есть картинка, и есть задача - как представить эту картинку в виде линейной кобинации элементов W (алфавита) и так, чтобы у нас был разреженный код. ISTA/LISTA решает эту задачу. Но ISTA/LISTA - итеративные алгоритмы градиентного спуска. Долго. А что если аппроксимировать? Конечно - добавляем энкодер, который “обнюхает” картинку и вернёт то, какие это должны быть коэффициенты линейной кобмниации.
class MainModel(nn.Module):
    def __init__(self, hp):
        super().__init__()
        self.W = nn.Linear(in_features=hp.kernels_count, out_features=hp.kernel_size**2, bias=False) # matrix of "reverse" filters, each row = dict elem
        self.K = nn.Linear(in_features=hp.kernel_size**2, out_features=hp.kernels_count, bias=True) # future kernels (what we want to train in PSD), each row = kernel
        # due to tanh nonlinearity output of tanh(self.K(X)) is limited to -1..+1. Gain is used to scale this value back to what ISTA predicts.
        # N.B.: z coeffs after ISTA may vary in hundreds!
        # [KavukcuogluFastInferSparse]: "gain coefficients allowing the outputs of F to compensate for the scaling of the input,
        # given that the reconstruction performed by B uses bases with unit norm"
        self.G = nn.Parameter(torch.ones(hp.kernels_count))

    ForwardResult = namedtuple('ForwardResult', 'wz xk')

    def forward(self, X, Z):
        # expected X.shape = (batch, image_as_vector)
        # expected Z.shape = (batch, coeffs_as_vector)
        wz = self.W(Z)
        xk = self.predict(X)
        return MainModel.ForwardResult(wz=wz, xk=xk)

    def predict(self, X): # a-la encode
        pred_z = F.tanh(self.K(X))
        # expected pred_z.shape = (batch, coeffs_as_vector)
        pred_z = self.G * pred_z
        return pred_z
И вообще, кажется, что вот этот подход: есть генеративная система, а давайте аппроксимируем её вывод (inference) какой-то более простой feed-forward сеткой - такой подход кажется очень плодотворным. И кажется, что это в нашем мозгу и в больших языковых моделях делается неявно. Т.е. есть куча генеративных моделей, но мы их аппроксимируем, т.к. вывод генеративных моделей дорог. Но жить как-то надо и жить надо быстро, поэтому везде и всегда появляются аппроксиматоры. Это, кстати, бьётся с идее ГЕНЕРАТИВНОСТИ в #90. Ещё это бьётся с идей Energy Based Models [LeCunTutEBM]: даны x (наблюдение) и какое-то приближение y (внутренее состояние) - требуется так модифицировать y, чтобы оценка F(x,y) была минимальна. Вообще про Energy Based Models отдельно надо осмыслить.
Ещё интересно, что можно генеративную систему можно аппроксимировать не только автоэнкодером. Но можно как в LISTA - сделать unfolding итеративных шагов в сетку (https://gist.github.com/kocherovms/dac4400d189abcb414ef5dfb8e1d233d). Т.е. сетка реализует цикл. Это вообще крышесносительная идея!
Свёртка как сильный регуляризатор. Вот возьмём пресловутуют зону V1. Можно подумать, что каждый участок зоны анализирует свой участок сетчатки. Тогда получается огромная сетка. Но в этой сетке будет много повторений, т.к. паттерны одни и те же, только в разных локациях будут. Поэтому зона вынуждены будет копировать между колонками (?) паттерны. А теперь бёрем свёртки. По факту у нас есть ядро свёртки, которое повторяется много раз по сетке, но только это повторение сделано в виде вычисления, а не в виде топографической карты. То есть так, можно свёртки развернуть и представить в виде большой сетки. Но тогда при обучении пришлось бы а) либо как-то ограничивать веса (регуляризация) б) либо копировать их туда-сюда. Ещё иначе - свёртка - это свёрнутая топографическая карта a-la V1. Видимо это и имелось в виду [HintonDropout] “This reduces the net’s representational capacity, but it also reduces its capacity to overfit, so dropout is far less advantageous in convolutional layers.” Типа CNN и так сильный регуляризатор сам по себе.
Интересная информация на странице LeCun по Sparse Coding https://cs.nyu.edu/~yann/research/sparse/index.html:
- оригинальный подход Olshausen (09_sparsenet)
- predictive sparse decomposition (11_cnn)
- LISTA
- Convolutional PSD
- Convolutional Matching Pursuit
- Learning Invariant Features with Group Sparsity
- Learning Locally-Connected Filters with Group Sparsity
Тренинг в s4_psd_01 реализует что-то наподобие EM алгоритма. Кстати, такой же был и у Olshausen. Сначала фиксируем W и К, находим Z. Потому фиксируем Z и вычисляем обновление для W и К. Повторяем.