96) 12_rnn (LSTM)
В рамках прокапывания [РашкаML]. Глава 15 предвосхищает трансформеры. В главе рассматривается простая модель на базе LSTM (продвинутый вариант RNN, который умеет “забывать”), которая предсказывает следующий символ на основе поданных на выход символов. Интересно стало попробовать переписать модель, чтобы она работала на уровне слов. Это что-то типа ближе к трансформеру по духу.
В итоге родился подпроект 12_rnn. Точность предсказывания составляет 99,4% для окна из 9 токенов, версия модели 105. Скачок в точности объясняется работой LRScheduler типа plateau.
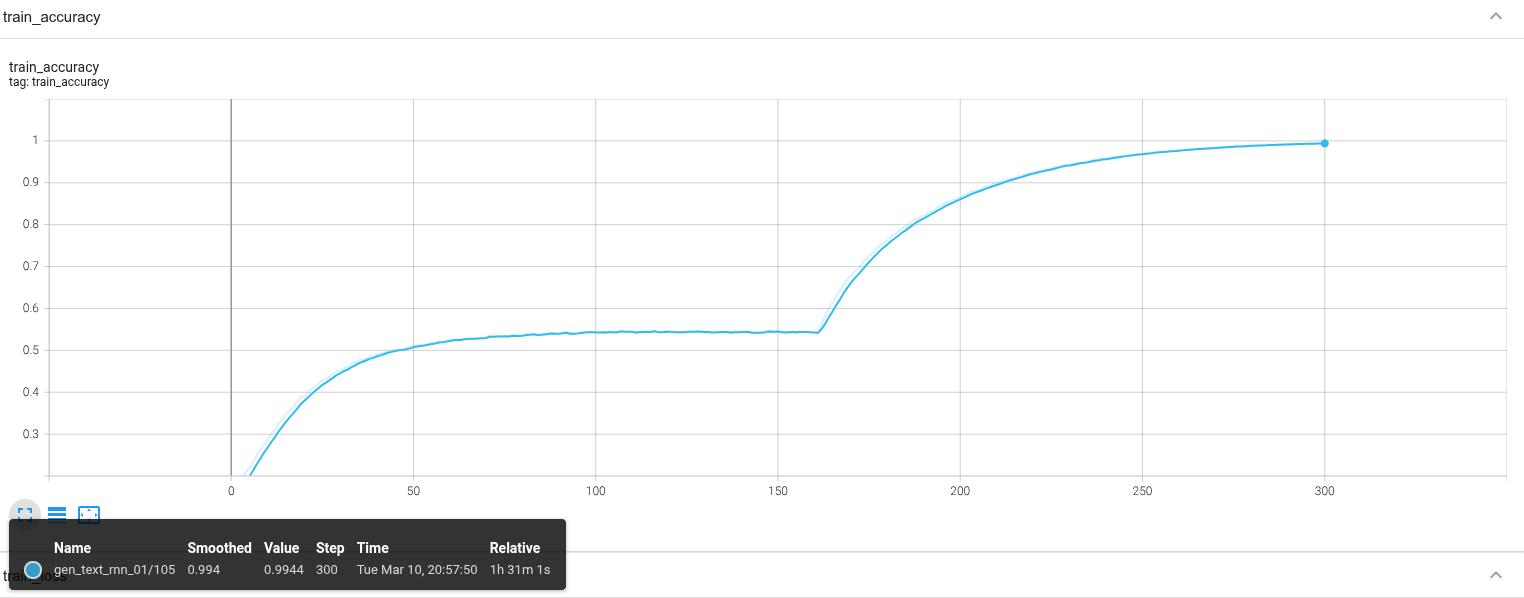
Вообще такая точность удивительная, т.к. архитектура модели достаточно простая: есть слой эмбеддинга (512) и один LSTM юнит (1792).
{'random_seed': 42,
 'db_fname': 'bundle_5_10_word.db',
 'embedding_size': 512,
 'state_model_units': ['LSTM(1792)'],
 'lr_model_units': [],
 'max_chunks_count': 100000,
 'batch_size': 100,
 'epochs_count': 300,
 'optimizer': 'Adam',
 'learn_rate': '0.001,plateau()'}
Кол-во токенов в словаре более 36_000 и, я полагал, что корпуса из 5 текстов не хватит. Но, оказалось, что вполне хватает и такого небольшого корпуса. Вероятно, сработало то, о чём писал в заметке #95.
Что вынесено из упражнения:
1) RNN, и LSTM в частности, имеют большую ёмкость для запоминания. Я пытался использовать несколько слоёв LSTM (вплоть до 4-х), но это не давала никакого выигрыша, а только удорожало тренинг. Возможно на бОльшем корпусе это было бы и осмысленно, а на мелком корпусе - никак не сказывалось
2) RNN, и LSTM в частности, действительно тренятся медленно. Отчасти это скрывается тем фактом, что в интерфейсе torch в эти модули можно скормить целую цепочку, что создаёт ложное ощущение, что обработка происходит однотактово. На самом деле внутри там стоит обычный цикл, который пробегается по всем токенам и протаскивает их через все рекуррентные слои. В итоге это ОЧЕНЬ долго. Неудивительно, что в архитектуре трансформеров это был одним из основных лейтмотивов.
3) RNN, и LSTM в частности, являются stateless. Это хорошо. Они возвращают свой hidden/cell state, который можно либо сохранить и пробросить в следующий вызов, либо выбрость. Таким образом, в зависимости от того что нужно, можно реализовать разные вещи
4) ChunkDataset для организации датасета, состоящего из большого набора чанков - полезно будет для трансформеров
5) max_chunks_count - сколько чанков на эпоху. 10% от корпуса на базе слов оказалось достаточно. Кажется, что можно и меньше. Т.е. нет необходимости в эпоху проходить весь корпус, достаточно проходить какое-то подмножество.
6) TextPreprocessor
7) subproject.py, как способ переписпользования кода внутри подпроекта
8) np.fromstring для быстрого декодинга списка токенов, разделённых запятой
9) начинать репортинг следует с эпохи 0, и в эту эпоху НЕ проводить никакой тренинг. Т.е. на 0-ой эпохе мы смотрим, как отвечает ненатренированная модель. Это формирует осмысленный baseline для дальнейшего тренинга
10) удобно хранить исходный корпус текста на nexus, а сгенерированные чанки уже хранить в ChunkDataset