102) эмбеддинги снова
Состоялся интересный диалог с Gemin: ./dialogs/transformer_intution.ipynb
Среди прочего было вынесено углубленноё понимание эмбеддингов, до этого понимание на самом деле было поверхностным =(
Итак. Я думал, что в эмбеддинг каждая размерность - это отдельная фича. Типа если размерность 256, то мы и кодируем 256 фичей. И как бы данные, которые система обрабатывает, вот и раскладываются на эти 256 фичей. Это называется disentangled representation (Disentangled Features). Это работающая схема, но она имеет ограничение по масштабируемости. Что если у нас 1000, 10000, 1000000 фичей? Нам что, делать вектора эмбеддингов такого размера? А если фичи появляются с течение жизни? Нам что, тогда закладываются на будущее, и большую часть жизни ресурсы будут простаивать? Далее, в каждый момент времени активны только несколько фичей (мы же не можем думать о всем сразу). Получается тогда, что в каждый момент времени в векторе будет только небольшая часть элементов активна, а большая часть - будет нулями. Т.е. разреженность большая.
И вот из диалога выясняется:
> You are missing the distinction between Disentangled Features (where 1 dimension = 1 trait) and Distributed Representations (where features are “smeared” across many dimensions). In a true vector space (like an LLM or the brain), “Acidity” is not Index #42 in a 300-element list. Instead, “Acidity” is a direction (a vector) within that 300-D space.
Т.е. фичи - это всего лишь направления, вектора! А т.к. мы имеем дело всё таки с HDV (hyperdimensional vectors), то есть известный факт, что два рандомных векотра в гиперпространстве (читай в пространстве эмбеддинга) будут почти ортогональны. Т.е. сколько векторов не возьми, они будут почти ортогональны. Или другими словами степень коррелированности будет низкий. Около 5%.
Тогда, грубо говоря, 10_000 или 100_000 или даже 1_000_000 фичей можно рассматривать как базисные векторы - они будут почти ортогональны даже в 300D размерности.
ВАЖНЫЙ МОМЕНТ! По факту мы хотим работать вот с этими миллионами фичей. Но в лоб это невозомжно и очень накладно. Поэтому мы, надеясь на “почти” ортогональность фичей в гиперпространстве чуть меньшей размерности (немного пародоксально звучит, т.к. по сравнению с миллионами фичей, пространство в 300 или даже в 1000 измерений не выглядит гипер, но тем не менее), будем их записывать в эмбеддинг вектор. Т.е. эмбеддинг вектор будет являться своего рода “ковчегом”, где временно живут фичи из настоящего гиперпространства, кратно большей размерности.
Конечно, вот эта “почти” ортогональность, она имеет накладные расходы. Эти расходы в том, что если закодировать несколько фичей в один эмбеддинг вектор, и потом попытаться прочитать, то наряду с закодированными, мы получил и значения фичей, которые туда не клали. Это из-за коррелированности. Фантомные фичи начинают возникать. Поэтому а) кол-во фичей, которые можно “запаковать” в эмбеддинг вектор ограничено, б) нужны механизмы борьбы с фантомным фичами (например, отсев шума по некоторому порогу).
Ноут 14_embedding/feat_ortho_emb_01.ipynb. Тут был эксперимент с целью выяснить, сколько фичей можно запихнуть в 300Д и какая степень коррелированнсти будет?
ВЫВОДЫ: 1) для размерности 300 можно спокойно разместить больше миллиона квазинезависимых (низкая степень коррелированности) фичей. 2) средний уровень коллинеарности (коррелированности) около 5% 3) 64% имеют порог коррелированности <5% 4) 96% имеют порог коррелированности <10% 5) распределения корреляционных коэффициентов похоже на экспоненциальное или полунормальное
Ноут 14_embedding/full_capacity_emb_02.ipynb. Тут был эксперимент следующий, есть кол-во фичей равное размерности пространства. Фичи инициализированы рандомно и изначально будут слабокоррелированным. Можно ли их декоррелировать?
ВЫВОДЫ 1) Если кол-во фичей не превосходит размерность гиперпространства, то можно выйти на ортогональный базис - провести декорреляцию 4) При этом фичи будут кодироваться/декодироваться без ошибки. Т.е. мы итеративно приходим к тому, что получили через QR декомозицию 5) Поиск базиса напоминает автоэнкодер. Или это автоэнкодер напоминает поиск базиса
Последнее заставляет немного по другому смотреть на то, что делается в nn.Linear. Уж не декорреляция ли там происходит?
Ноут 14_embedding/over_capacity_emb_01.ipynb. Тут уже экстремальный кейс рассматривался. Размерность пространства 768, кол-во фичей 100_000, одновременно пытаемся запихнуть 100 фичей в эмбеддинг вектор. Какие это будут фичи - выбирается рандомно. Т.е. никакой структуры нет, все фичи могут встретиться друг с другом с одинаковой вероятностью. Что-то типа плоского ландшафта.
Мы тут имеем дело с undercomplete базисом (100_000 >> 768), поэтому декоррелировать фичи невозможно в принципе - декоррелируешь одну группу, сломается в другой группе, если эти группы пересекаются (а пересекаться те или иные группы будут стопроценто). Но интересно было посмотреть, а что вообще возможно вытянуть из декорреляции.
ВЫВОДЫ
1) Чуда, конечно, не случилось - декоррелировать столько фичей невозможно
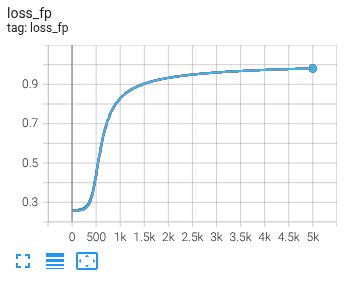
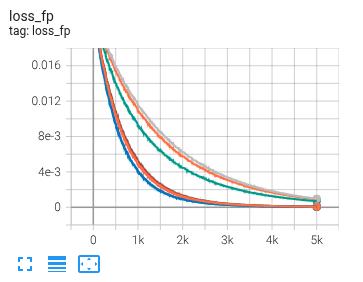
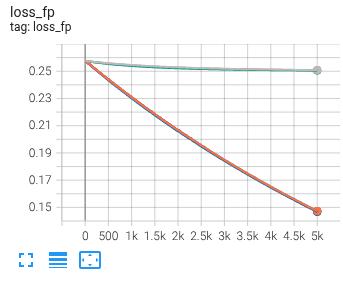
2) Если для оптимизации смотреть на loss_tp (смотрим только на потери при кодировании 100 фичей), то в жертву сразу приносятся фичи, которых не было. А таковых $100000-100=99900$. Кол-во фантомных фичей растёт, и вообще непонятно, как отделить зёрна от плевел (даже никакой bias не помогает)
Real-valued фичи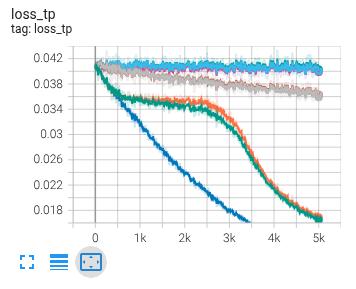
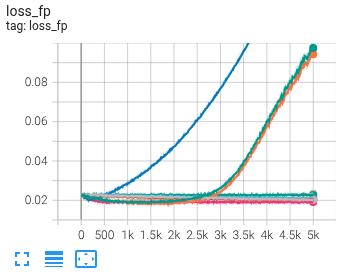
Binary-valued фичи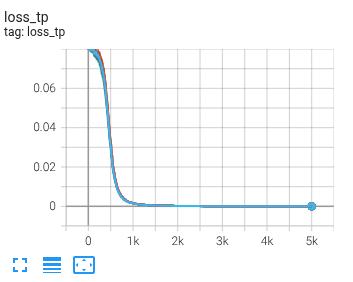
 4) Если для оптимизации смотреть на
loss_all (смотрим потери всего вектора), то тут настоящие фичи просто приносятся в жертву и система сосредотачивается на моделироании нулей. Т.е. системе проще считать, что везде 0 и победа.
Real-valued фичи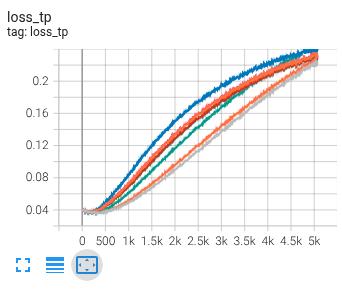
Binary-valued фичи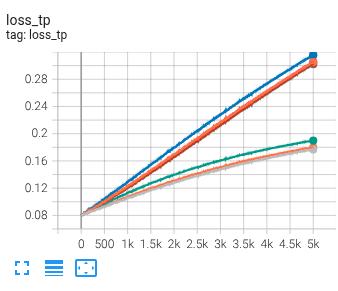
 4) Если не нормализовывать векотора, то система начинает “читить” - просто уменьшает веса фича-векторов, с тем, чтобы свести всё ближе к нулю (ведь у нас 99% нулевых фичей).
5)
ReLU для real-valued фичей, Sigmoid для binary-valued
6) забавно, что само собой вылезает потребность в bias (threshold) - он нужен, чтобы отсекать фичи по шуму. Иначе вот ты смотрешь на значение после декодинга и не понимаешь: это такое знаение фичи или это просто шум? Забавно при этом, что обычный глобальный bias (скаляр) лучше работает, чем векторный (кодга для каждого измерения свой bias)
Как же наш мозг работает в такой ситуации? Ведь ему нужно работать с коррелированными фича-направлениями? Пока нашёл два ответа. Один из ответов - это порог шума, мы просто отсекаем все значения, ниже этого порога. Второй из ответов - это эксплуатация совместного сосуществования фичей. Т.е. определить активна ли фича (или это фантомное значение) можно по тому, а активны ли её сотоварки, т.е. те с которыми она чаще всего ходит. Ведь каждый набор фичей - он образует некоторое подпространство, некоторую предметной область. Типа фичи, описывающие напитки, фичи, описывающие настроение человека, фичи описывающию управление авто и т.д. И тогда если фича активна, и эта фича типа встречается в группах 1, 2 и 3, и при этом эти группы молчат, то значит и фича эта фантомная. А если, например, активны другие фичи из 1 или 2, то, значит, у нас многозначность есть и можно на явление посмотреть в с т.з. группы 1 или группы 2.