104) интерпретация microgpt
Ноут gists/microgpt/microgpt.ipynb. Интерпретация с т.з. Vector Brain модели.
1) материал для начальной текущей мысли - это последний токен. Да, именно так. Не первый, а именно последний. Если бы это был полноценный GPT, то, как ни странно, материалом для начальной мысли бы могла являться точка в конце повести =)
2) дальше работает телепортация: мы приземляем токен в embedding space в соответствии с таблицей токенов и получаем начальную текущую мысль. Потом сразу подправляем её через добавление вектора positional embedding.
3) по всем предыдущим токенам мы строим KV матрицы - одна KV матрица для каждого слоя.
4) дальше текущая мысль продвигается через слои.
5) на каждом слое делаем одно и то же: Attention + MLP. И там, и там мы вычисляем nudge вектор и модифицирем текущую мысль
6) в Attention nudge вектор вычисляется исходя из истории. Работа ведётся независимо в каждой башке Attention. Для этого в каждой башке мы сверяем текущую мысль (через W_q) с тем, что доступно в истории (через W_k на токены). Получаем для каждого токена его вес (attn_weight) - насколько он релевантен текущей мысли. Затем извлекаем из историчных токенов разные фичи (W_v) и взвешиваем их с attn_weight. Таким образом получаем вектор полезной выразительности фичей. На основе последнего вектора и вычисляется nudge вектор от Attention.
7) в MLP nudge вектор вычисляется уже просто, глядя на текущий мыслевектор. Мы сначала вычисляем ключи полезных/релевантных фактов через fc1 + relu. Затем берём эти полезные/релевантные факты и выбираем поправочные вектора в соотсветствии с весом - линейная комбинация.
8) в конце из текущей мысли берётся логит следующего токена через проекцию
Самое главное. Текущая мысль - это последний токен. Думаю, что мог бы быть любой токен, но не суть. И далее эта текущая мысль проплывает через слои, и на её пути на неё, как магниты, влияет вся цепочка токенов (кстати, в которую цепочку последний токен тоже входит). Таким образом эта текущая мысль многократно отклоняется и в конце концов приземляется куда-то в embedding пространстве. Далее уже просто идёт декодинг финальной позиции в распределение (логиты) токенов.
Если сравнивать с RNN, то там мы каждый токен вынуждены обрабатывать последовательно. Т.е. мы как бы движемся по оси времени. В transformer мы берём последний токен (аки столп) и как-бы запускаем, как шар в боулинге через слои модели, а предыдущие токены выступают как магниты на дорожке. Таким образом зависимост от длины входящей последовательности убирается, т.к. на обработку что 100, что 1000 токенов будет примерно одно и то же кол-во ресурсов задействовано и вообще один вызодв модели будет нужен, тогда как в RNN надо будет 100/1000 раз модель дёргать.
Да, при инференсе, когда работает авторегрессия, мы что с трансформером, что с RNN, будем делать одно и то же - вызывать последовательно. Тут преимущество от одномоментного обработки всей цепочки исчезает.
Но при обучении трансформер можно быстро обучать в режиме Parallel Teacher Forcing. Типа раздялем работу - каждой GPU даём свою задачу, первый GPU обрабатывает первый токен и предсказывает второ, второй GPU - обрабатывает первые два токена и предсказывает третий и т.д. За счёт этого происходит накопление градиентов, которые потом в точке синхронизации объединяются и делается один общий backprop. Тут подробнее: transformer_intution.ipynb
UPD 2026-04-17
Важное уточнение про “Текущая мысль - это послений токен”. Тут можно неверно соскользнуть в понимание, что будто бы имеет значение только последний токен, а все предыдущие - это только так - материал для KV. И типа поэтому предыдущие токены можно как-то более лайтово обрабатывать. Но на самом деле нам нужно протащить все токены по всем слоям и через все слои внимания и через все слои MLP. Причина в том, что каждый уровень имеет входными данными мыслевектор с предыдущего уровня, а не с первого. См. картинку. Чтобы рассчитать KV для первого токена на слое 2 - нужно прогнать этот токен через внимание на слое 1 и MLP слоя 1 и только тогда получить мыслевектор E12, от которого уже будет плясать слой 2. Если бы слой 2 брал данные непосредственно из T1, то тогда это была бы совсем другая история.
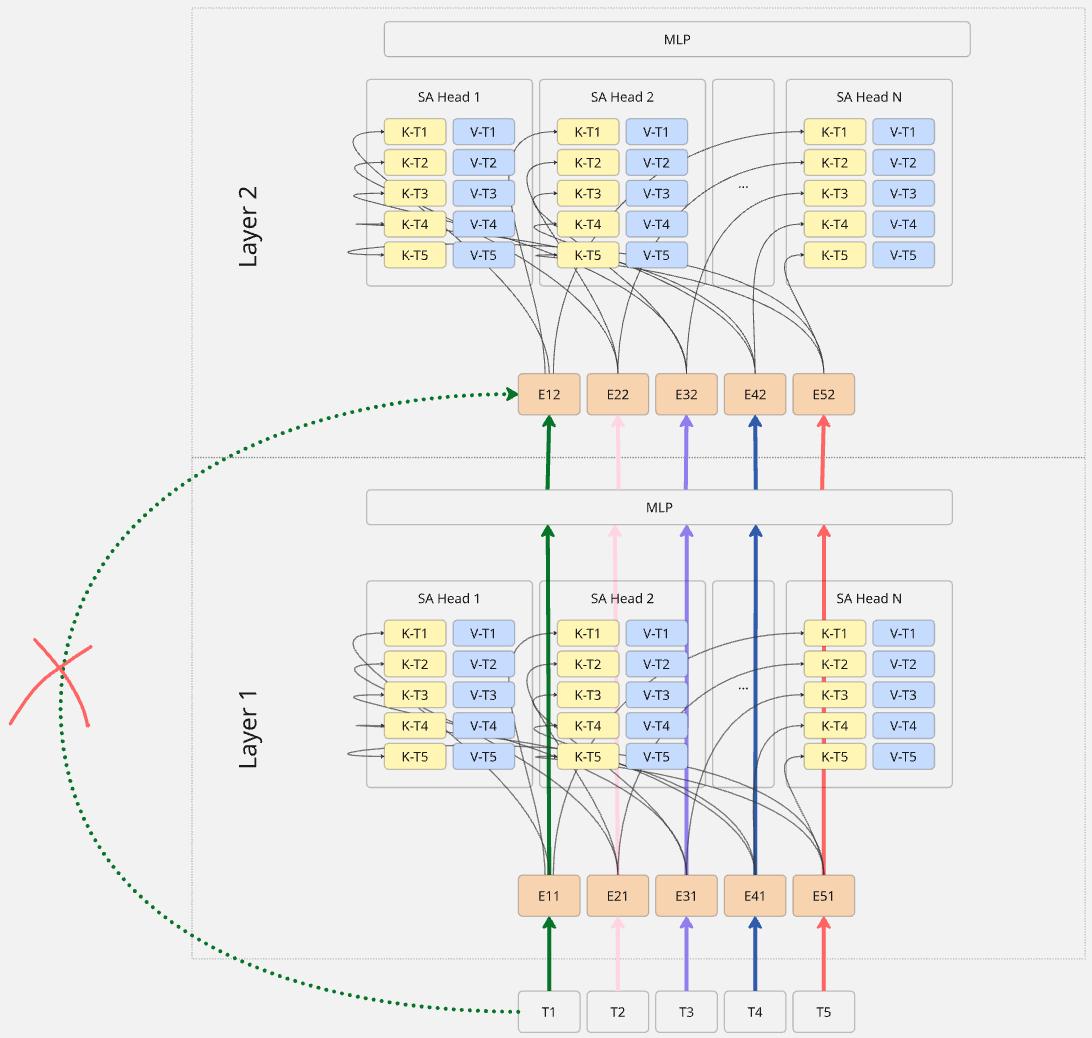
Собственно из-за этого становится поятным, почему на выходе из nn.TransformerEncoder мы имеем предсказания для каждого токена. Казалось, бы это лишнее, когда нам нужно предсказание только для последнего, но именно так оно и работает. Протаскивая каждый токен через все слои эти предсказания получаются как-бы сами собой, без них всё равно нельзя.