105) causal transformer
Подпроект 15_transformer. Идея:
1) разрабатываем словарь (vocab) патчей (например, 5x5 или 7x7). Кол-во элементов в словаре ограничено, например, 128. Для этого можно заюзать решения по basis pursuit. В принципе можно из всех базисов (элементов словаря) выбрать один - самый лучший.
2) каждую MNIST картинку описываем в виде набора патчей. Получается что-то типа свёртки, где каждому положению скользящего окна сопоставляем элемент словаря. Т.е. что-то типа: “В позиции x,y находится патч, описываемый элементом словаря z”.
3) далее обходим картинку по какому-либо правилу, например, зиг-заг или спираль из центра. Получаем цепочку токенов. Подпитываем каждый токен позиционным кодированием (т.е. где этот токен расположен).
4) это очень похоже на то, с чем работают трансформеры. Есть цепочка токенов и надо предсказать следующий токен
5) строим трансформер, которые научается для каждой подцепочки из цепочки предсказывать следующий токен
6) по идее модель должна выучить верхнеуровневые штуки, чтобы предсказывать следующий токен
Промежуточные результаты:
1) 15a_vocab_02.ipynb - формирование словаря. Много идей из 11_cnn. Только вместо ISTA был сделан более простой bp_batch_solo - выбор одного лучшего базиса из всех. Визуально получились интересные базисы: 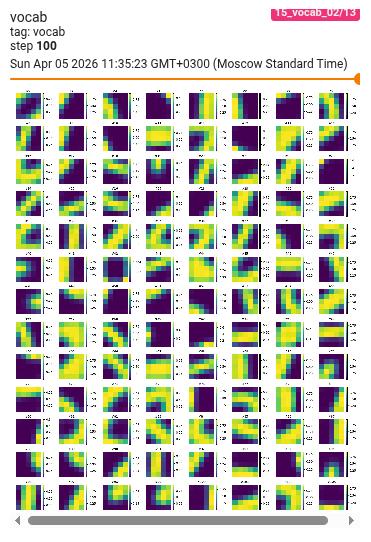 2)
15b_encode_01.ipynb - для каждой картинки делаём свёртки со словарем. Получаем связку: позиция патча - vocab элемент.
3) 15c_sample_01.ipynb - из 576 токенов, сформированных энкодеров выбираем штук 25 по определённому алгоритму: зигзаг, спираль. Это будущий вход для трансформера - обход картинки в каком-то известном порядке
4) 15d_predict_casual_01.ipynb - собственно трансформер, который обучается предсказывать следующий элемент цепочки
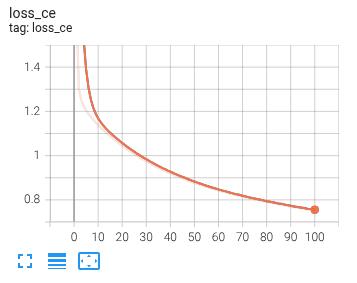
Модель как-то работает. На тренинге при обучении показывает улучшение, но на тестовых сэмплах есть признаки переобучения.
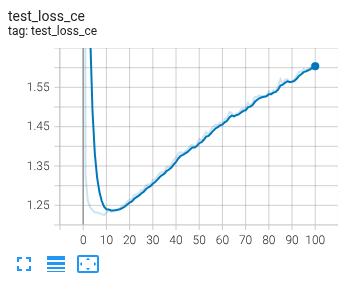
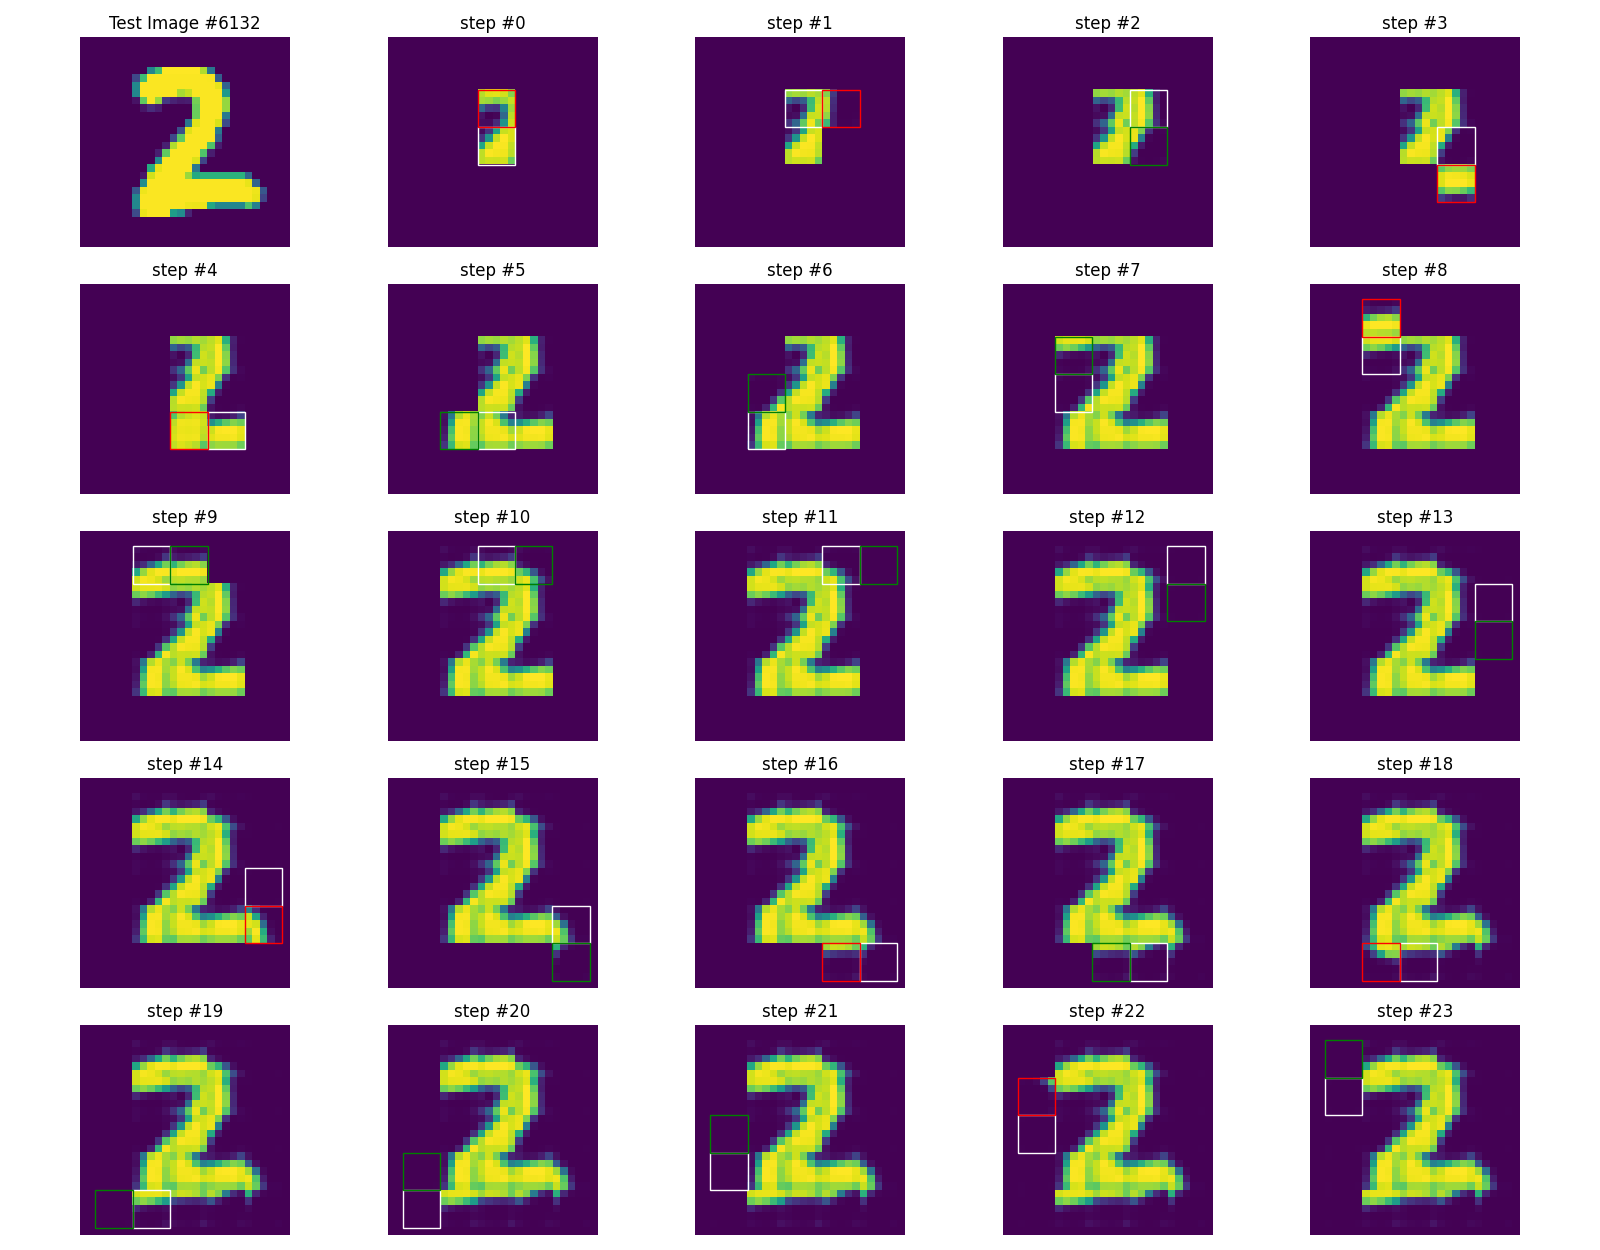
При этом на тестовых сэмплах видно, что модель всё таки что-то предсказывает: если квадритик красный - не угадала, если зелёный - угадала.
Можно было бы побороться с переобучением (например, поиграться в кросс-валидацию), но несколько фундаментальных причин заставили отказаться от этой идеи: 1) всё таки хотелось, чтобы модель умела работать в noncausal режиме. Т.е. когда нет последовательности, а есть известные набор данных и надо по нему восстановить оставшиемся слоты. Примерно, как наше зрение работает - мы фиксируем несколько точек и сразу понимаем оставшееся. 2) слишком строгий критерий в функции потерь - требуем, чтобы патч был предсказан 100%. Но ведь тут существует взаимозаменяемость патчей. Если три элемента словаря, описывающих что-то типа вертикальной линии, то если модель предсказывает одну из них - это всё равно плюс. Мы же не засчитываем это вообще никак. Т.е. мы ставил модели либо 5-ку (идеальное предсказание), либо кол. Хотя модель может и на 4-ку ответила - предсказала вертикальную линию, пусть и не такую точную. Короче, кросс-энтропийный лосс должен быть с вероятностями, а не категорийный
Разницу между causal и noncausal режимами удалось выявить в ходе диалог сессии: torch_transformer_mlm.ipynb. Выжимка оттуда:
> I’ve gained following intuition on casual and bidirectional mode for nn.TransformerEncoder so far. > > Casual mode. Go through the sequence, for each subsequence predict next token looking at tokens behind. > > Bidirectional mode (noncasual mode). Go through the sequence, predict current token looking and all other tokens. > > I’m not talking about performance issues right now. I’m focusing on high-level goal of each mode and generic mechanics below. > > Is my intuition correct?
ИТОГО. Надо двигать в сторону noncausal трансформера с поддержкой кросс-энтропийного лосса с вероятностями.