106) noncausal transformer
Короче, ставка на noncausal трансформер была правильной. Для моделирования визуала - это то, что нужно. Грубо говоря, представляем картинку в виде набора токенов (в моём случае 25 токенов), максируем сколько-то токенов (например, 20% или 40%), заставляем модель восстановить замаскированные токены. В итоге модель как-то обучается структуре данных и боль-мень восстанавливает токены.
Сначала была парочка моделей 15d_predict_noncausal - это модель только умела предсказывать замаскированные токены. Потом захотелось прикрутить ещё и классификацию, чтобы модель отвечала на вопрос - а что это за картинка. Появилось 15e_classify_noncausal. Классификатор реализуется путём внедрения нового токена [CLS], который “впитывает” в себя инфу из других токенов, и потом, глядя на этот цлс токен, можно классифицировать картинку. Ну а потом вообще в разнос всё пошло - а почему бы сразу и заполнитель, и классификатор не тренить. Так появились 15f_combo_noncausal - тут сразу и маскированные токены восстанавливаем, и классификтор обучается.
Отдельная опупея была с расчётом вероятностей топ-3 токенов. С одной стороны нужно было сделать так, чтобы когда есть явный супер-пупер чемпион, то вероятности должны быть вплото до OHE вектора - это особенно важно для токенов в пустоте. Делание torch.softmax в лоб не сработало - получалось всегда что-то типа 33% процентов. Ну это и понятно, т.к. разброс логитов был очень низкий. После диалога с джемини (https://share.google/aimode/PAIz4RUL5GvL0y7HV) удалось найти ratio-based подход, при котором вполне вменяемые вероятности стали получаться.
В последнем 15f_combo_noncausal был заход ещё и на поляну augmented датасета - трансфомируем случайным образом картинки (немного поворота, немного трансляции), токенизируем их, маскируем и потом передаём в модель. Это конрастирует с подходом, когда всё через БД делалось. Просто стало понятно, что модель хуже справляется с классикацией, когда, например, добавляются небольшие смещение по x/y (это можно в тензорборде увидеть по модели 15f_combo_noncausal_01). И через БД это никак не решить, т.к. вариантов трансформаций очень много. Поэтому только онлайн-вычислять. И уж тут, пришлось реализовывать DataLoader, который в фоне в несколько потоков готовит батчи. Сразу стало понятно, что это такой за зверь collate_fn в DataLoader. Появились AugmentedDataset и AugmentedDatasetItemsCollator (тут диалоги были https://share.google/aimode/IIuB5zp0SrRkP86Xa). Вкратце схема такая:
- запускается несколько воркеров
- каждый воркер готовит батч
- батч готовится путём получения дата айтемов из
AugmentedDataset, а потом список айтеом передаётся в коллатор. Коллатор уже накинет трансформации, вырежет патчи, токенинизирует патчи, построить матрицы вероятностей, маскирование сделает и вернёт это в виде словаря - в основном потоке выбирается воркер, который готов, у него забирается патч. Воркер приступает к готовке следующего батча
Test accuracy последней комбо модели.
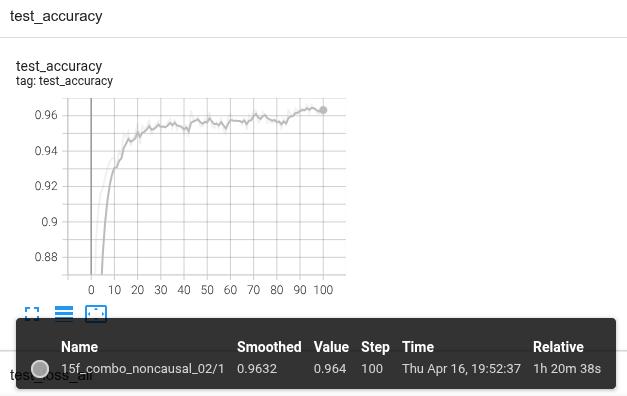
ВАЖНО test_accuracy не супер-впечатляющий, т.к. модель трениться на маскированных данных, в т.ч. где 40% токенов замаксировано. Поэтому неудивительно, что для столь сильно замаскированных данных test accuracy занижен.
Предсказания последней комбомодели.
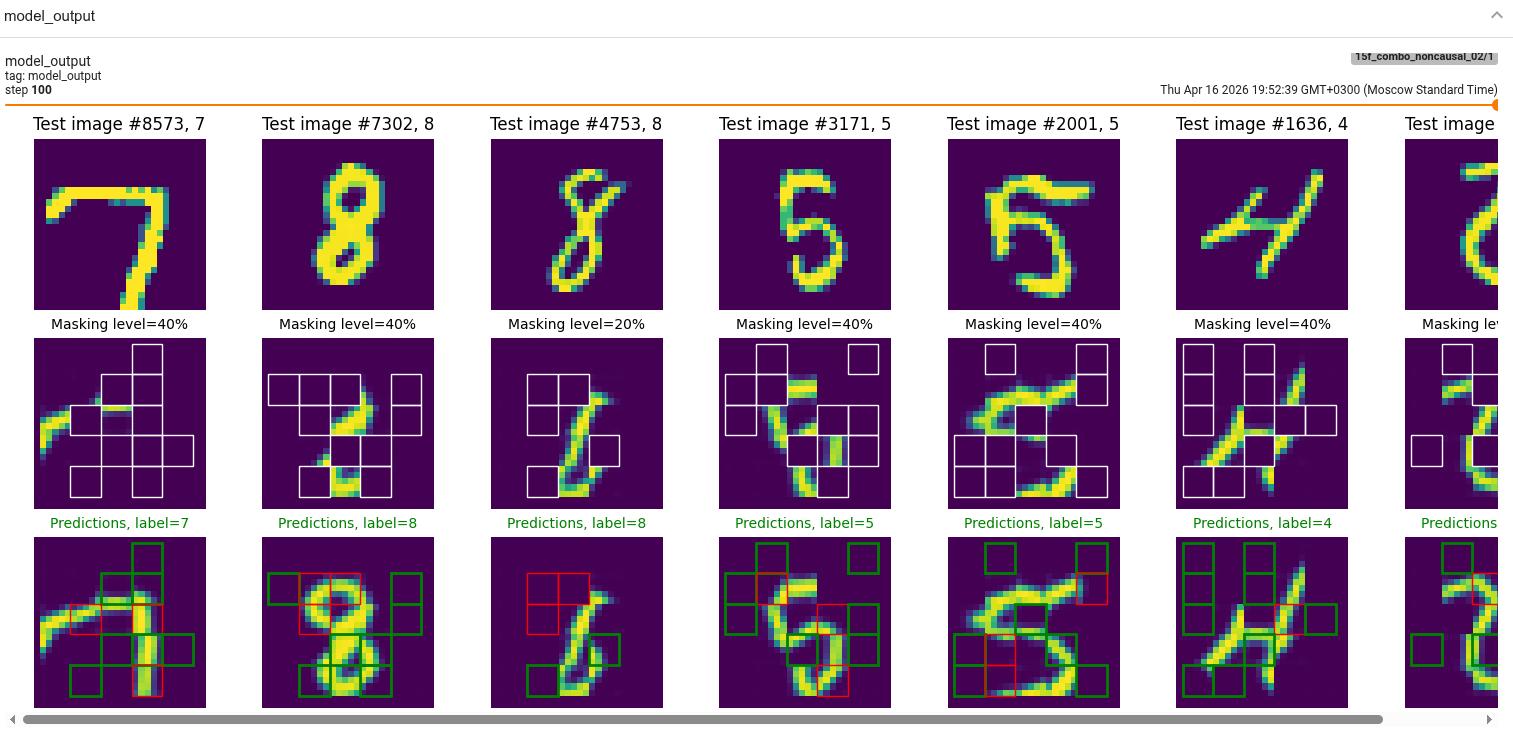
Видно, что модель неплохо заполняет пропуски. Причём даже когда мы помечаем красненьким (типа не угадала один из топ-3 вариантов) видно, что токены не случайны, а даже осмысленны, что-ли.
Ещё удобным оказалось разрабатывать отдельно ноуты для просмотра результатов модели. Всё таки перегружать ноут, где трениться модель, очень неудобно - слишком много логики, проблемы с launchit постоянные, потеря фокуса. Таким ноутм стал 15g_explore_combo_noncausal - в нём можно надевелопировать кучу всяких визулизаций и через запуски можно сравнивать разные версии моделей.
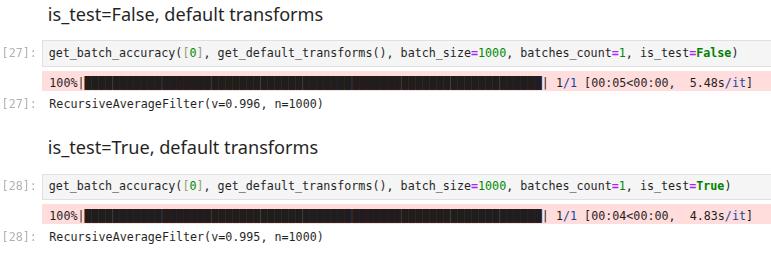
В том же эксплорере протестирована классификационная сила моделей:
| Испытание | 15f_combo_noncausal_01:3 |
15f_combo_noncausal_02:1 |
|---|---|---|
| С трансформациями | 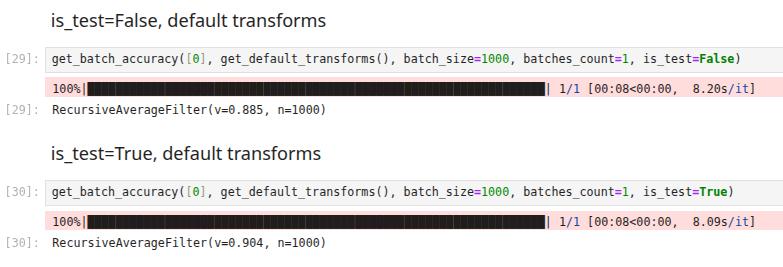 |
 |
| Без трансформаций | 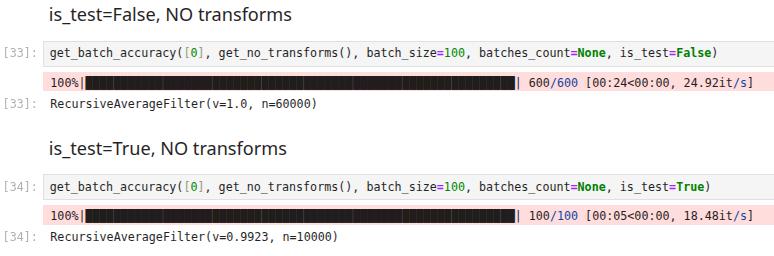 |
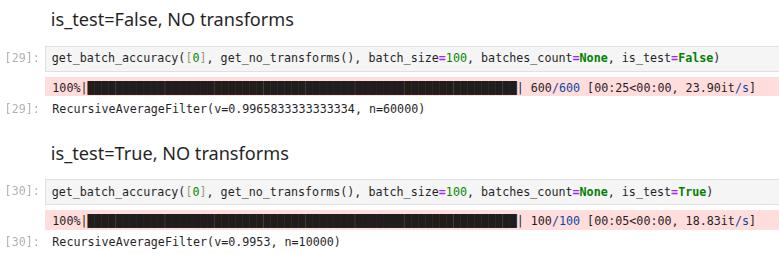 |
Видно, что 15f_combo_noncausal_02:1 ощутимо точнее (99,53% vs 99,23%). Это и понятно - она тренилась на augmented датасете.