108) Hybrid: CNN+Noncausal Transformer
Стал думать о девелопировании агента, который бы играл в Атари. Собственно, это и была изначальная мысль проекта neurovision - наработать опыт, как считывать визуальные сцены.
В ходе диалога с Джемини родилась верхнеуровневая архитектура:
- noncausal трансформер отвечает за восприятие сцены
- causal трансформер отвечает за планирование след. действий
- оба связаны через очередь: NT поставляет данные, CT потребляем и вырабатывает действия
Встал вопрос - а как NT будет анализировать сцену? В проекте 15_transformer картинка разбивалась на 25 пачтей-токенов. И там это можно было сделать, т.к. имелся словарь токенов. А в игре как? Тоже словарь заводить?
Поэтому в диалоге выяснилось, что можно состряпять гибридную модель: CNN+NT. И CNN типа сразу будет выдавать результать в эмбеддинге пространстве трансформера. Во как. Вообще это получается что-то типа Denoising/Masking Autoencoder. Только здесь нелинейный, как это было раньше.
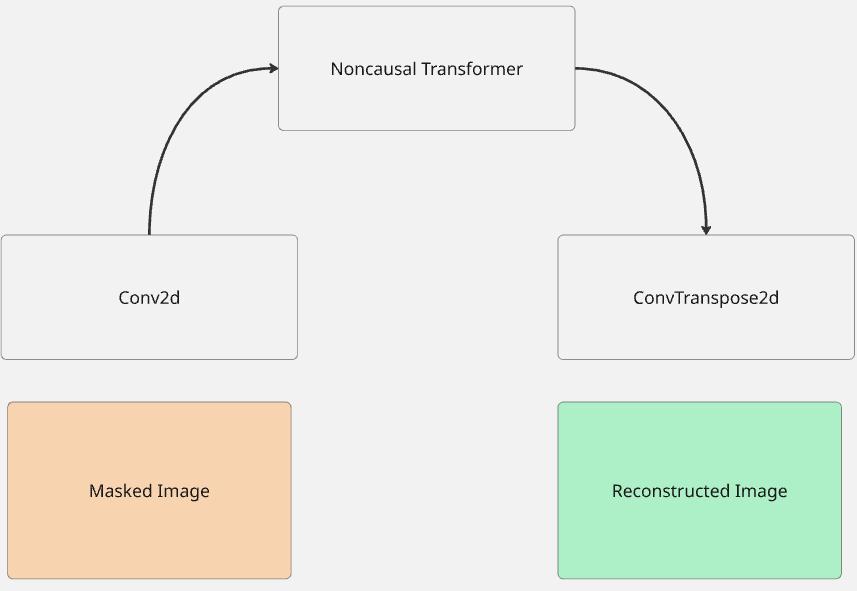
Чтобы протестировать и отработать идею родился подпроект 16_hybrid. Цель была а) отработать гибридную модель б) проверить, что гибридный трансформер способен дообучаться.
Поэтому кроме MNIST картинок ещё до кучи взял изображения цифер из Chars74k. Как оказалось, довольно таки приличные датасет, изображения цифирек имеются в разных вариациях.
На этот раз на разработку 16_hybrid ушло 4 дня, что достаточно быстро. Результаты порадовали. Со всякими маскировками и трансформациями модель достаточно уверенно ведёт себя и корректно классифицирует и восстанавливает маскированные картинки. И это, учитывая размер картинки 128х128.
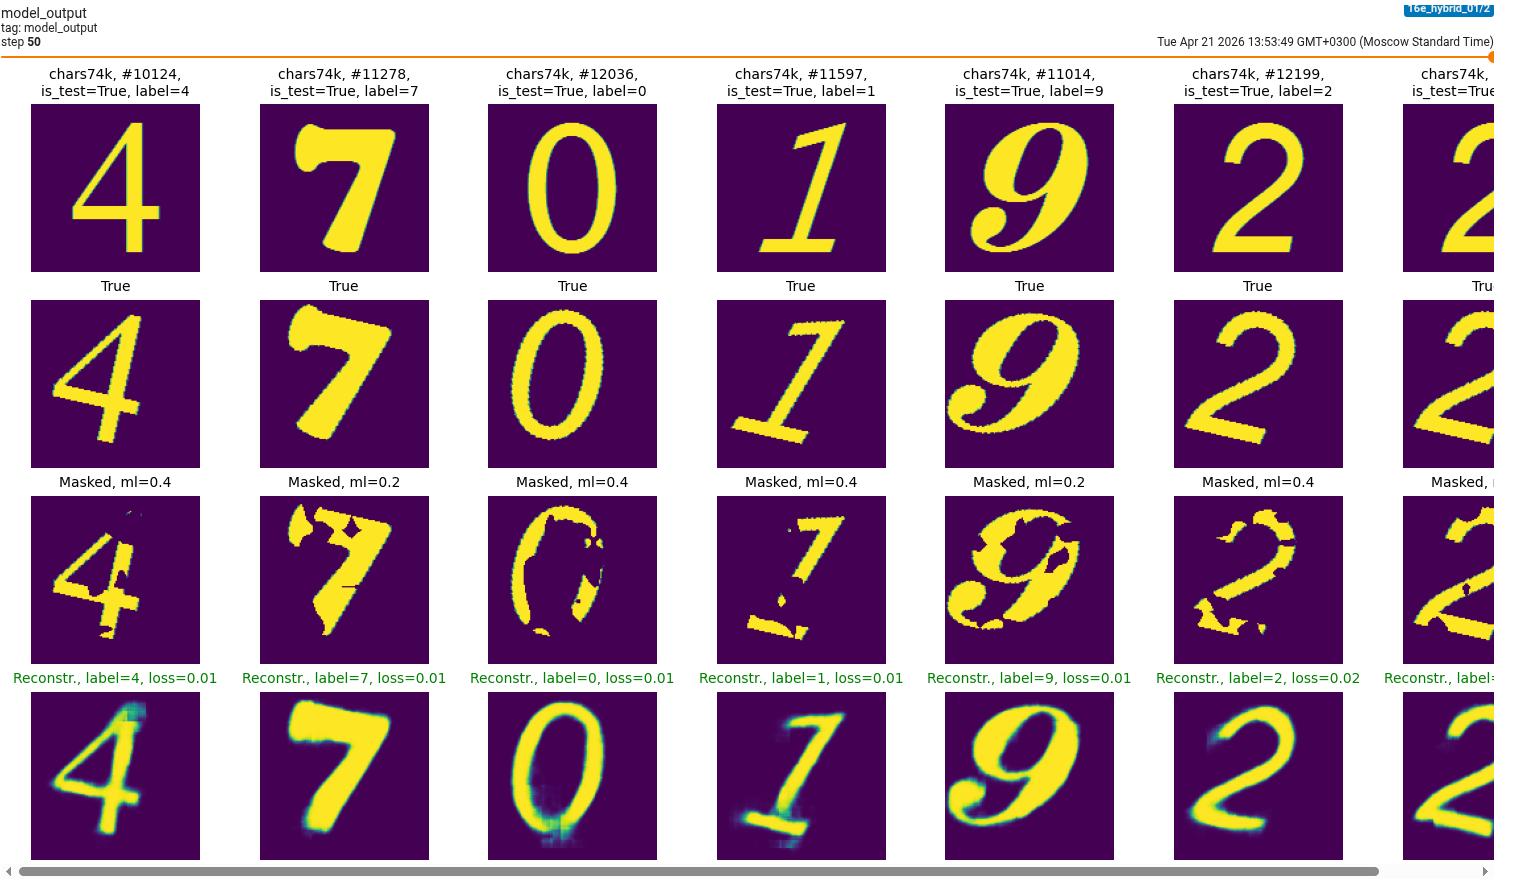
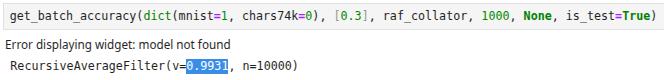
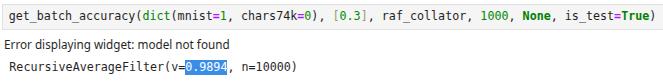
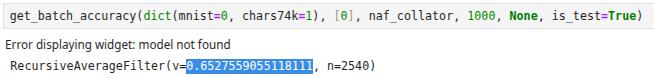
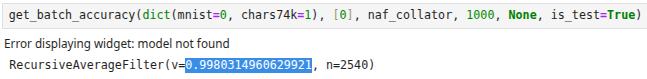
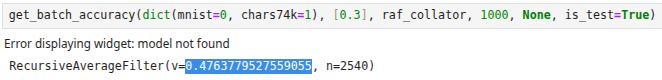
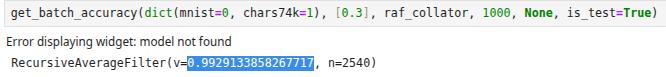
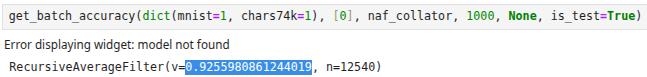
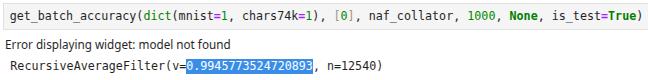
Две версии модели 15e_hybrid_01:1, 15e_hybrid_01:2. Вторая версия есть зафайнтюненная первая версия: взял первую версию и дообучил её разбираться с Chars74k.
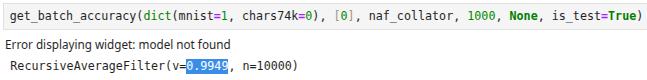
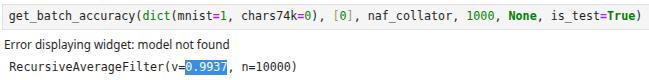
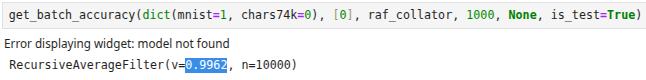
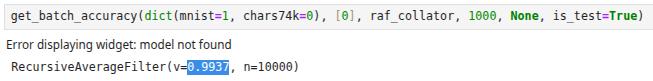
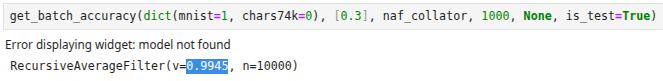
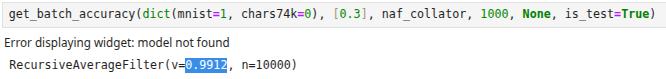
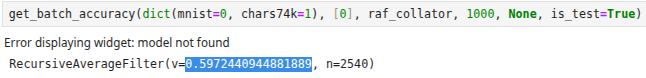
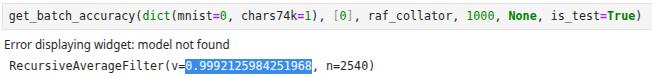
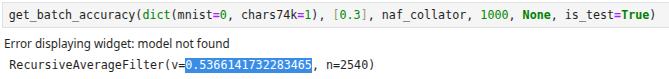
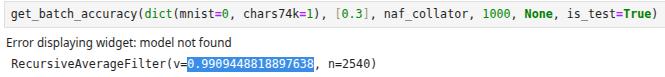
Перформанс метрики:
15e_hybrid_01:1 |
15e_hybrid_01:2 |
|---|---|
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
 |
ВЫВОД:
Если рассматривать neurovision как проект, чтобы натаскаться в работе с визуалом, то кажется, что Hybrid - это good enough вариант. Т.е. можно делать ставку на визуальные трансформеры.