109) PPO Atari
Первое упражнение по вкатыванию в RL тему. Ноуты: 17a_ppo_atari_02, 17a_ppo_atari_mp_02, 17a_ppo_atari_envpool_01.
Начал с PPO - proximal policy optimization. Типа один (наряду с DQN) популярных алгоритмов на данный момент. Сущность разобрана и законспектирована в реферате на [ShulmanPPO]. Если вкратце то нужно собирать траектории игры агента фиксированной длины. Сам агент представляет из себя комбинацию критика и актора. Актор вычисляет следующее действо, критик оценивает будущую отдачу. Далее вычисляется преимущество (advantage) актора, как разница между тем, что получилось по итогу действий актора и того, что предсказал критики. Если имеется положительное преимущество, то смещаем через policy gradient веса модели в сторону того, чтобы эти действия сохранялись. Также тюним критика, чтобы он лучше предсказывал отдачу.
Вообще главной проблемой RL, как я понял - это сбор данных. Точнее собрать их не проблема, но это ОЧЕНЬ медленно. Мы должны играть в игру и по крупицам набирать опыт. По сравнению с обучением с учитилем или без учителя - RL на порядок сложнее. Поэтому больше плясок не вокруг модели агента или алгоритма оптимизации, а то, как мать его, быстро собрать обучающий набор данных.
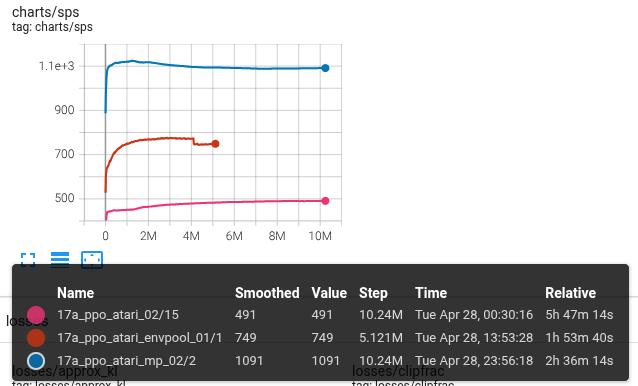
Вариантом, на котором в итоге остановился - 17a_ppo_atari_mp_02. Почти в два раза быстрее чем 17a_ppo_atari_02. Тупо запускаем несколько воркеров, каждый из которых умеет делать rollout политики. Поэтому результаты этих роллаутов собираются, политика обновляется и рассылается воркерам. Т.о. образом в несколько рыл исследуем окружение (environment). По производительности к 17a_ppo_atari_mp_02 близок 17a_ppo_atari_envpool_01. Правда там разъехался код envpool-а с Gymnasium. Плюс в envpool-е нет v4 версий Atari. Короче, свои моменты.
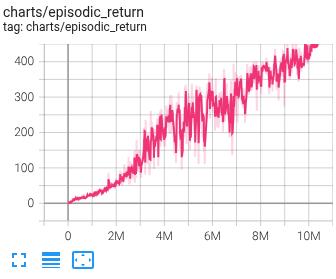
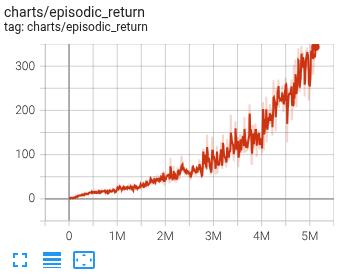
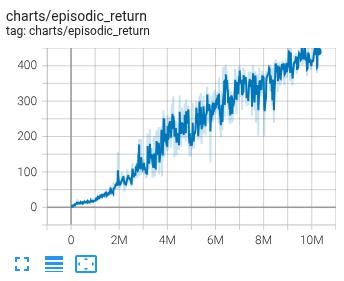
В целом каждая из реализаций достигает 400+ очков.
17a_ppo_atari_02 |
17a_ppo_atari_envpool_01 |
17a_ppo_atari_mp_02 |
|---|---|---|
 |
 |
 |
Шагов в секунду