110) DQN Atari
Второе упражнение по вкатыванию в RL тему. Ноуты: 17b_dqn_atari_02, 17b_dqn_atari_mp_03. Первый - однопроцессный с векторизированным окружением. Второй - многопроцессный.
DQN выглядит попроще, чем PPO. Тут нет никаких роллаутов, нет ни критиков, ни акторов, не нужно вычислять GAE. Просто тупо непрерывно выполняем политику и как можно чаще уточняем её (обучаем агента). В идеале на каждый шаг нужно делать learn. В качестве цели обучения мы берём максимальный TD(1), т.е. заглядываем на шаг вперёд и ищем там оптимальное продолжение. Соответственно от суммы “текущее вознаграждение + максимальное вознаграждение от следующего состояния” мы и стимулирем в плюс или минус агента выбирать текущее действо. Т.е. если видим, что текущее действо хорошо, то стимулируем делать и дальше, если видим, что хреново, то дестимулируем. По факту стимуляция/дестимуляция зашита в значение действия, которое зависит от состояния, т.е. $Q(s,a)$.
Из-за того, что необходимо часто (в идеале на каждый шаг) делать обучение агента, то узким местом становится основной поток. И параллелизация помогает намного меньше, чем параллелизация в PPO. Именно поэтому в референс имлементации использовалось векторизованное окружение из одного элемента и 4 шага на прогон (learn_step_period).
Короче, очень долгий алгоритм. 10 млн шагов на брейкауте на референс имплементации занимает более 11 часов обучения.
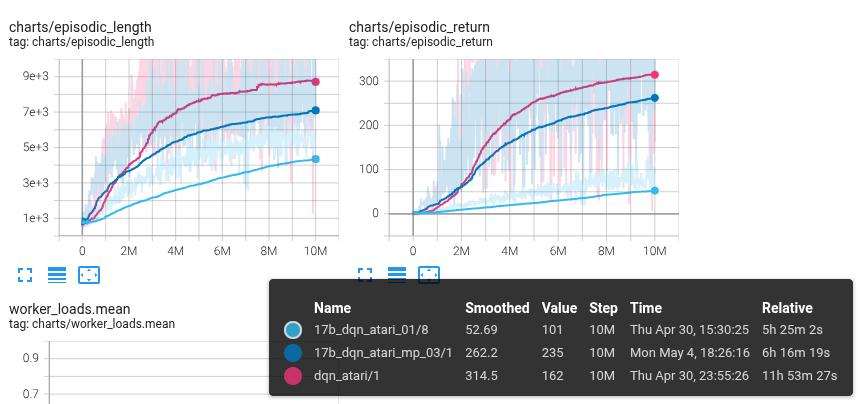
Комментарий относительно кривой эффективности обучения. Разница объясняется следующими параметрами: |имплементация|last episodic_return|envs_count (workers_count)|learn_steps_period| |—|—|—|—| |dqn_atari/1|314.5|1|4| |17b_dqn_atari_mp_03/1|262.2|2|4| |17b_dqn_atari_01/8|52.7|8|32|
Ну т.е. видно, что добавление параллельных окружений (что через векторизированный вариант, что через многопроцессность) толку не даёт, а делает только хужее.
Вот тут ещё интереснее картинка:
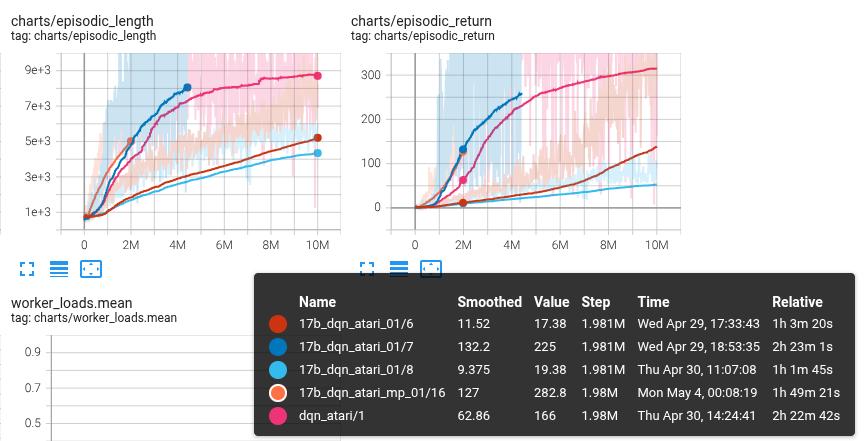
Видно, что 17b_dqn_atari_mp_01/6 наряду с 17b_dqn_atari_01/7 даже идут лучше, чем референс на 2 млн шагов.
|имплементация|last episodic_return|envs_count (workers_count)|learn_steps_period|
|—|—|—|—|
|dqn_atari/1|63|1|4|
|17b_dqn_atari_mp_01/7|128|4|4|
|17b_dqn_atari_01/7|132|1|4|
Короче, DQN как-то не очень дружит с паралелльностью, либо нужно увеличивать кол-во шагов (чтобы наверстать обучение по сравнению с однопроцессной версией), либо выигрыш по времени поулчается незначительным.