111) PPO + TransformerXL MemoryGym (MortarMayhem, MysteryPath)
Третье упражнение по вкатыванию в RL тему. Ноуты: 17c_ppo_trxl_memory_04, 17c_ppo_trxl_memory_mp_03, 17c_intuition.
В данном упражнение используюстя кастомные игры из набора Memory Gym - среда для тестирования памяти (умения запоминать) агентов. Опорная статья [PleinesMemoryGym].
Используем агент на базе трансформера. По ходу роллата формируется трейс скрытых состояний. Для обсчета текущего наблюдения агент также использует скрытые состояния из этого трейса. Сколько этих скрытых состояний определяется параметром memory_length. Например, 128 прошлых состояний. Итак, агент берёт текущее наблюдение и через attention подтягивает данные из прошлых состояний. Таким образом текущее наблюдение, проходя через слои трансформера, обогащается данными из прошлого. Скрытые состояния, которые получились в ходе обработки текущего наблюдения, сохраняюстя и добавляются в трейс. Из интересного того, что за счёт CNN мы “сворачиваем” всё текущее наблюдение в одну точку сразу в пространстве d_model. Т.е. текущее наблюдение грубо говоря представляется одним токеном. Да, ещё используется positional encoding на базе синусоид, который добавляется на каждом уровне трансформера к скрытыми состояния памяти.
Основной вызов и куча логики (от которой голова пухнет) - это на самом деле решение одной проблемы. Каким образом прокинуть трейс скрытых состояний со стадии роллаута на стадию обучения. Это можно сделать в лоб - на каждом шаге роллаута тупо сохранять трейс скрытых состояний в отдельном участке памяти. Но тогда мы воткнёмся в проблему нехватки памяти. Т.к. трейс скрытых состояний на шагах $t$ и $t+1$ отличается несильно, то мы по факту будем сохранять одно и то же. И если в хостовую память м.б. это и поместится с горем пополам, то на GPU места не хватит. В итоге приходится городить сложные конструкции с промежуточными индексациями и скользящими окнами. Сначала использовал batched_index_select из референсной реализации. Поэтом перешёл на torch.unfold для формирования виртуальных окон для данного трейса. Ну и тогда мы можем просто сохранять номер окна. Другая связанная проблема - это батчинг для тренинга. Даже если бы мы сохранили для каждого шага роллаута свой уникальный трейс, то возникает вопрос - как это объединить в батч для тренинга. Короче, либо batched_index_select, либо torch.unfold. Остальное всё - это обслуживание этого механизма.
Ещё выяснилось, что всё это время (в PPO, DQN, PPO+TrXL) использовался неправильный метод авторестарта для векотризированных окружений. Нужно было использовать SAME_STEP, а я использовал NEXT_STEP. Меня смутило то, что враппер AutoRestart реализует только NEXT_STEP семантику, поэтому и для SyncVectorEnv тоже выбрал такую. Хотя на самом деле удобнее SAME_STEP. В противном случае придётся городить управление состояниями при роллауте. Эта проблема была незаметна до тех пор, пока не попробовал игру MysteryPath. Там сразу вылезло то, что агент легко добегает до максимального кол-ва шагов в игре и при авторестарте все начало ломаться, т.к. собственный счётчик шагов рассинхронизовался с внутренним счётчиком окружения.
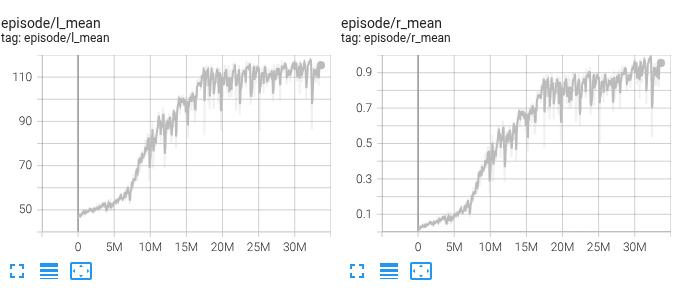
Графики с MortarMayhem
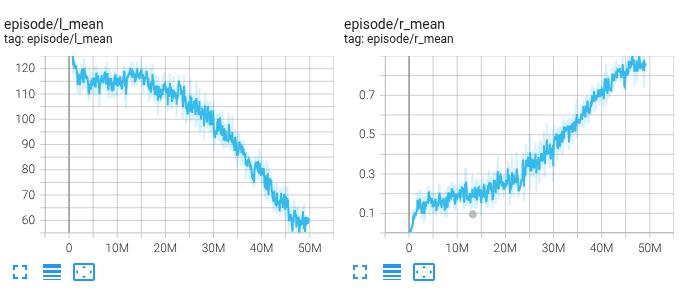
Графики с MysteryPath
РЕЗЮМЕ
Решения из PPO+TransformerXL можно использовать для разработки агента, играющего во FrostBite.