112) PPO + TransformerXL/Transformer Atari Frostbite
На оптимизме быстро адаптировал 17c_ppo_trxl для игры в Atari Frostbit: 17d_ppo_trxl_atari_mp_01. Агент умудряется нахоботить порядка 526 очков за эпизод (запуск 17d_ppo_trxl_atari_mp_01/3). Но есть проблема: он не научается заходить в иглу. Вместо этого он прыгает по льдинам, меняет их направление, рабирая тем самым строящееся иглу, и продолжает дальше прыгать по льдинам. В ходе диалогов с Джемини стало понятно, что TransformerXL не очень подходит для этой задачи (from_trxl_to_tr.ipynb). Главная причина в том, что скрытые состояния, которые агент собирает после первого же обновления весов превращаются в тыкву. Поэтому было принято решение отказаться от TransformerXL и перейти на классику, когда собираются observations и по ним уже и решение принимается (get_action_and_value) и обновление весов идёт.
Ок, сказано сделано. Переполз на вариант 17e, где мы собираем observations и потом на них же и обучаемся. Т.е. никаких скрытых состояния, чисто исходные данные. По ходу было много улучшений сделано. Основное: а) перенос масштабирование и перевод в grayscale на GPU, б) супер оптимальный цикл сбора и сохранения исходных данных (observations, padding masks, actions, values, advantages, returns), в) подсчёт игровых статистик отдельно за жизнь и эпизод в независимости от того, есть ли episodicLife или нет. Самый-самый запуск был 17e_ppo_tr_atari_mp_03/8 больше 779 очков за эпизод.
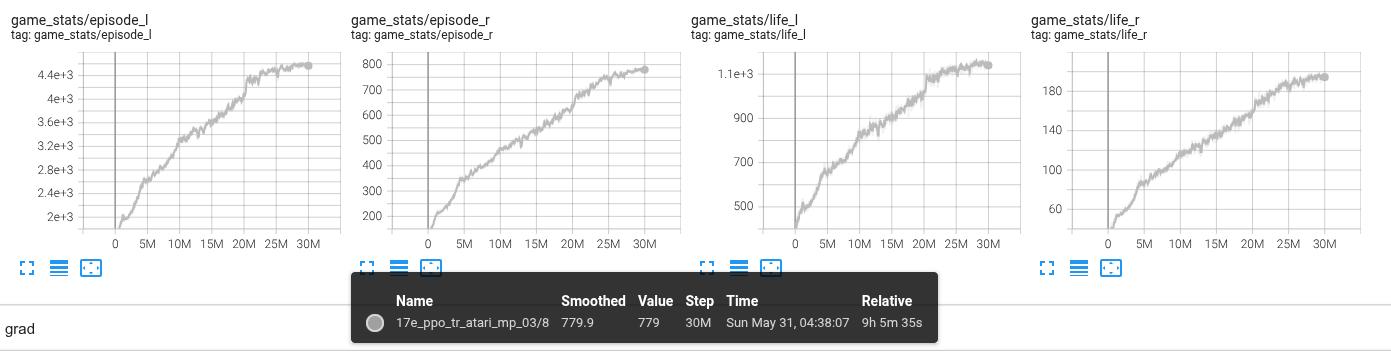
Однако по сути агент всё равно не заходит в иглу. Он просто более мастерски прыгает по льдинам, уклоняется от чаек, разбирает иглу и так далее.
В ходе другого диалог с Джемини (https://share.google/aimode/5m3vUlxbRBgEuvcMd) родилась идея сделать prediction head - научить агента предсказывать следующее состояние сцены (observation embedding). Кардинально это ситуацию не изменило, из заметного только то, что на первых поряд prediction head действительно помогает. Хотя по правде говоря надо больше экспериментов, т.к. я сделал только один запуск с prediction_coef=0.1.
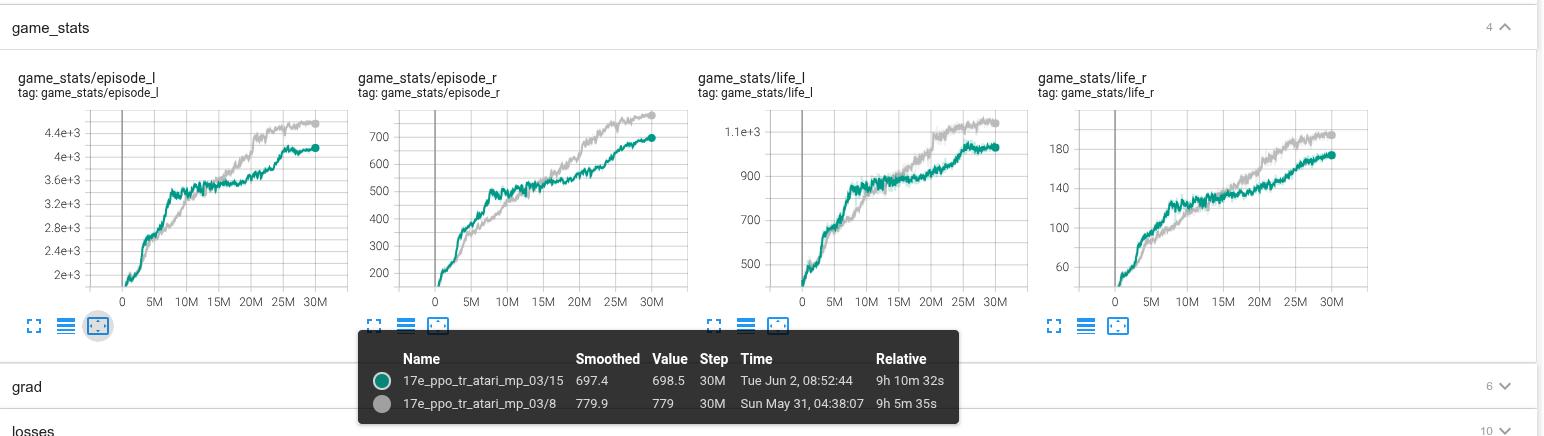
Ещё из интересного проработал механизм запусков через докер контейнер. Это удобно, если хочется запускать проект, например, в облачной инфраструктуре какого-нибудь Селектела или Яндекс клауд. Просто создаёшь там машину, деплоишь докер контейнер и запускаешь. Не надо мучиться с зависимостями и настраивать окружение. Хотя для для одного запуска PPO Atari на 30млн шагов потребуется где-то 1000 рублей - стоимость аренды железа в течение 8-9 часов.
Ладно. Так или иначе главное. Агент, сволочь такая, не хочет заходить в иглу и тем самым играет очень близоруко. В целом-то причина понятна: откуда агену знать, что такое иглу, и что в него надо зайти. Да, по идее это может произойти случайно, но для этого потребуется Оооочень много времени и Оочень много запусков. Попытка прикрутить prediction head - оно в правильном направлении, т.к. чтобы предсказывать состояние экрана, требуется понимать что сейчас на нём нарисовано. Т.е. как бы агент должен научиться описывать ситуацию, разработать внутри себя какую-то систему нарративов. Но этого видимо недостаточно. Человек то изначально умет планировать и действия подвязывать к плану. Поэтому когда видит иглу, то сразу догадывается, что с ним можно как-то повзаимодействовать. Агент этого лишён. У него нет ни опыта (что типа домик - это хорошо), ни навыков планирования. Он просто тупо умеет отрабатывать текущую ситуацию по нахобочению очков.
Тут как-бы идея, что надо добавить агенту навыки планирования. М.б. так, как это в TEM сделано - типа должна быть кольцевая двухщажная нижележащая структура, к которой действия привязывается. Вроде как верхнеуровневый FSM, а дальше уже действия в рамках текущего состояния этого FSM. Только как это выразить?
Про скорость исполнения. Две мысли:
1) Sample Factory (https://share.google/aimode/zpvOkrlQDutev8jdL), https://www.samplefactory.dev/
2) Speculative Rollout. До этого я сам додумался. Ведь можно исполнять get_action_and_value, например, 4 шага в спекулятивном режиме. А потом минимизировать расхождение. Таким образом агент будет, как бы в режиме мечтателя работать. А уменьшая расхождение он будет всё лучше и лучше понимать среду.