115) угл. curriculum + action planing Atari Frostbite
Ноуты 17e_ppo_tr_atari_mp_08, 17e_ppo_tr_atari_mp_09, 17e_ppo_tr_atari_mp_10. Два мощных изменения:
1) явно выделил Curriculum - управление планом обучения. Теперь можно создавать различные планы, например, просто рандомно иметь разные game_modifs или на ранних этапах одни game_modifs, на поздних другие. Короче, как хочешь, так и можно написать. Curriculum сохраняется в виде summary_writer.add_text в Tensorboard и поэтому можно сравнивать различные эксперименты (launch) между собой.
2) планирование цепочки действий вместо одиночного действия. Идея была сначала такой, чтобы научить агенты думать состояниями. Типа “вот я собираю блоки”, а потом “иглу готов, надо зайти”. Но потом я решил, что, наверное, проще будет просто заставить агента планировать на несколько шагов вперёд и вдобавок требовать, чтобы эти планы сохранялся преемственность. Т.е. чтобы план на шаге t+1 с большей вероятностью пересекался с планом на шаге t. Тогда по идее естественным образом должна формироваться библиотека стереотипного поведения. Тут долго обсуждал с Gemini curriculum+action_planning.ipynb
Ну и тут случается маленькая победа! Эксперимент 17e_ppo_tr_atari_mp_10/3, когда consistency_coef=0.1 и prediction_coef=0.1 показалю клюшку на табло.
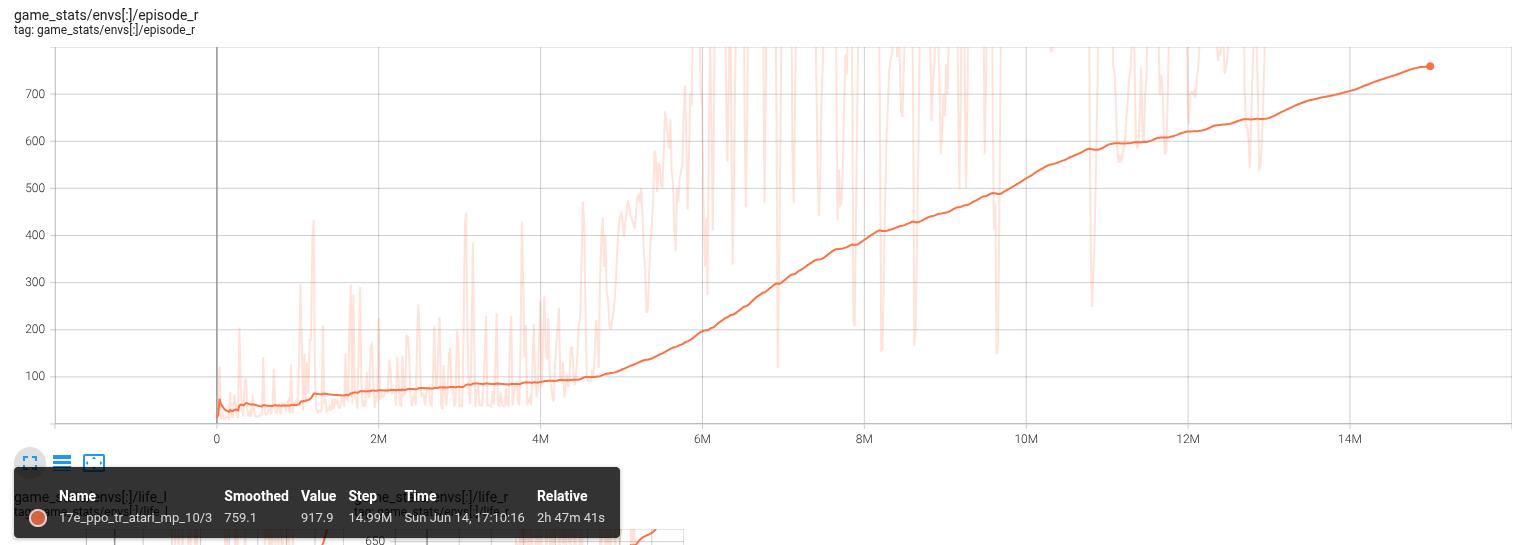
Агент научился проходить первый уровень сам от начала и до конца: собирает блоки, потом заходит в иглу. И даже умудряется проходить второй уровень. На третьем уровне, где крабы - погибает.
Попробовал другие эксперименты с разными значениями consistency_coef и prediction_coef. Всё оказалось хуже, чем, когда оба выставлены в 0.1. При этом отключение prediction ухудшает метрики. Т.е. получается нужно и планирование действий, и представление того, что будет на следующем шаге. Видимо, какая-то мощная регуляризация появляется.
Следующая большая цель: агент проходит уровень с медведем