127) 18_rl - реализация идей TEM
Что суть такое TEM модель? Это набор моделей, которые синхронизируются между собой, и через это умеют в unsupervised режима познавать реальность и предсказывать её. Есть две главные модели: генеративная и инференс модель. Генеративная - модель мечтатель, интегратор. Она на основе своего внутреннего представления и действий моделирует будущее - латентные переменные g. Чтобы понять, что она моделирует верно, она через модуль памяти предсказывает будущие сенсорные данные. Сигналом корректировки служит расхождение предсказанных и настоящих сенсорных данных. Инференс модель наоборот идёт от сенсорных данных и предсказывает латентные переменные g. И вот в такое интерплее модели учаться работать синхронно.
TEM-t - реализация TEM в виде трансформера. Память - это входящая последовательность. Работа с памятью - через механизм attention. Генеративная модель - RNN, которая вырабатывает лейблы (positional encoding) для входящих данных.
В лоб применить TEM-t для реализации агента - медленное и долгое обучения из-за наличия RNN. А потом на первый взгляд, непонятно, что есть g? В TEM g описывали местоположение на графе. А в игре тогда что? Местоположение игрока? Противников? Льдинок?
После долгих размышлений стало понятно, что суть g можно понять через то, на что оно влияет. А влияет оно на предсказание следующих сенсорных данных. Таким образом, если мы, имея g, можем предсказать следующий observation, то, значит, мы на верном пути. А что значит, предсказать observation? Ну можно его отрендерить. А как его отрендерить? Надо знать, какие объекты на сцены и что они делают? Таким образом, g - это внутренее состояние игры вместе с логикой. Имея g, можно взять ConvTranspose и получить рендер кадра.
Ок. А как получить g? Ну у нас есть набор observation. Прогоняем через трансформер, получаем вектор(ы) в embedding space. Эти векторы через ConvTranspose - получаем картинку. Сравниваем, получаем loss. Оптимизируем.
По-факту это уже давно было сделано в 17_rl, там где предсказывался next_obs. Только next_obs предсказывался в embedding_space, а тут можно его дальше отрендерить.
Возникла идея, а что если через вот “дальше отрендерить” построить отдельный pipeline со своим трансформером. На входе CNN, который выдёт сетку вектров на кадр (тупой CNN), дальше трансформер понимает суть происходящего на экране - выдет латентные вектора g. По этим векторам рендерим картинки, сверяем с настоящими. Через расхождение оптимизируем. В конце концов получаем CNN на входе, которые хорошо умеет разбирать входящее изображение на кирпичики (визуальные фичи). Потом берём этот CNN и перекидываем его в модель агента. Веса CNN можно вообще заморозить. И тогда пробелма #126, #125, #123, #121 будет решена на корню. Трансформер агенты вынужден работать на полную мощность. Вдобавок всего ещё и быстрее это будет, т.к. CNN будет заморожен (хотя и не обязательно).
Таким образом, 18_rl - изучение world model. По набору наблюдений задача - понять логику игры и научиться качественно предсказывать следующий обзервейшн. Для функции потерь - комбинация BCE + Edge loss. Для метрики качества - SSIM.
Первая версия 18a - тут была добыча данных через роллаут настоящими агентами. Стало понятно, что это лишнее - можно в оффлайне сформировать любого размера датасет и потом его потреблять. Таким образом, self-supervised обучение. Это уже 18b. Для качественной отрисовки стало понятно, что нужно несколько render heads. В итоге получается конструкция, которая на test dataset выдаёт SSIM>0.98:
- sequence_length=4
- ob_shape=(1, 178, 152)
- ob_grid_shape=(16,16)
- d_model=256
- layers_count=3
- heads_count=4
- spatio_temporal_encoding=separate
- render_heads_count=4
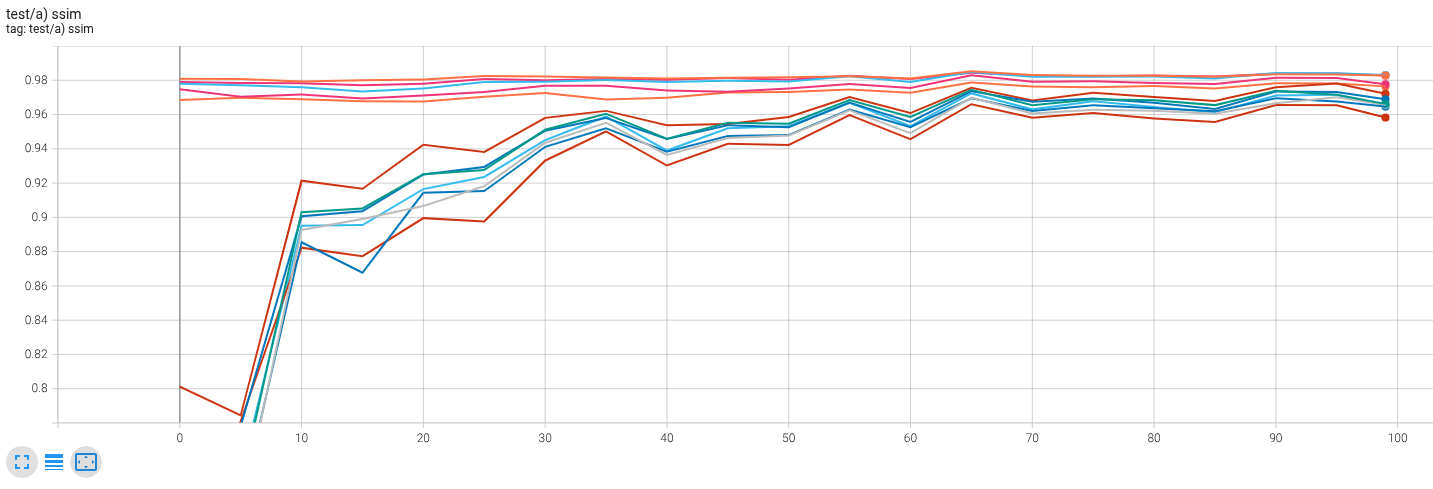
Тут правда другая проблема в полный рост. 4 кадра из гридов 16х16 - это 1024 токена, как с куста. Attention в трансфомрмере просто трещит по швам из-за квадратчности (нужна матрица 1024x1024). Пришлось прикручивать ещё и AMP (automatiс mixed precision) вместе с переключением на EFFICIENT_ATTENTION через spda_backend, чтобы хотя в 16Гигов укладываться.
Понятно, что таким образом про масштабирование можно забыть. Поэтому нужно более элегантное решение. Выход нашёлся в биолгии. Наше зрение не считывает всю картинку. Мы видим в фокальной области небольшой кусочек высокого разрешения, а дальше по мере удаления разрешение падает. Наш глаз совершает саккады, микросаккады, тремор. Короче наше ощущение картинки - это компиляция набора маленьких кадров на некотором временном горизонте. От этого есть всякие визуальные баги, но бенефит налицо - можно много больше и глубже информации обрабатывать.
Поэтому следующих шаг 18c - это сделать pipeline такой (https://share.google/aimode/WTU8gjxHwgXq4ZcW8): > I’ve lots of thought on how to organize new vision architecture and especially how to pick up foveal points (where model should look at current step). I wanted to settle with some universal solution which allowed me to pursue various goals. E.g.: > 1) given just a single observation and a number of glimpses over it - reconstruct whole observation. > 2) given set of observations and a single glimpse for each observation - reconstruct each observation. > 3) given set of observations and a single glimpse of each observation - imaging next observation.
> I.e. I could force model model to effectively learn both static structure and how things evolve over time (back and force).
> So I came to idea that I need a more complex pipeline: > 1) foveal point selector. This is a rough CNN (e.g. 4x4 grid) coupled with simple transformer. Goal: given observation produce number of foveal points (configurable parameter) in terms of x,y,std(x),std(y). I.e. produce parameters of Gaussian distribution from one could sample. > 2) spatial feature extractor. Given sampled foveal points for each observation extract features with different resolution. I think I just need two resolutions: fine-grained (e.g. 5x5) and middle-grained (e.g. 4.4) with extended area. Observation space is not so large (it’s not a Starcraft observations) to use 3 or more resolution grades. > 3) so I end up with a bunch of feature tokens for each observation which I label with temporal label and spatial labels. The remaining part of model is unchanged for now.
> Let’s discuss following moment. I have two options: > 1) glue everything together into a single long pipeline: foveal point selector + feature extractor + actual model. Then train everything together. > 2) setup a model interplay: train foveal points selector with other parts freezed, then train feature extractor and actual model with foveal point selector freezed.
> Any thoughts what is the preferred way?