131) 18d_world_model_07: факторизованная модель мира
Явное разделение WorldModel на:
Encoder- переводит обз. (178,152) в латентный вектор (256). Использует внутриVisionHead, который CNN 6x6Predictor- потребляет цепочку латентов от энкодера и на их основе предсказывает латент следующего обза.RenderHead- принимает на вход латенты и по ним возвращает обз. (178,152).
Цель была в том, чтобы легко унести Encoder в 18n_ppo_tr_frostbite и там использовать сравнение латентов, вместо рендеринга. Это откроет возможности для использования более длинных цепочек и тем самым решить проблемы тупизны агента, когда он не может разобраться с тем, он сдох или это очистка уровня идёт.
Как ни странно, для сравнения латентов подходит обычный MSE. Ещё пробовал InfoNCE. Штука красивая, но требует ещё доп. прожектор и по ssim, ниже чем MSE. См. исследования 18d_study_14.1, 18d_study_15.1, 18d_study_15a.1, 18d_study_16.1, 18d_study_17.1.
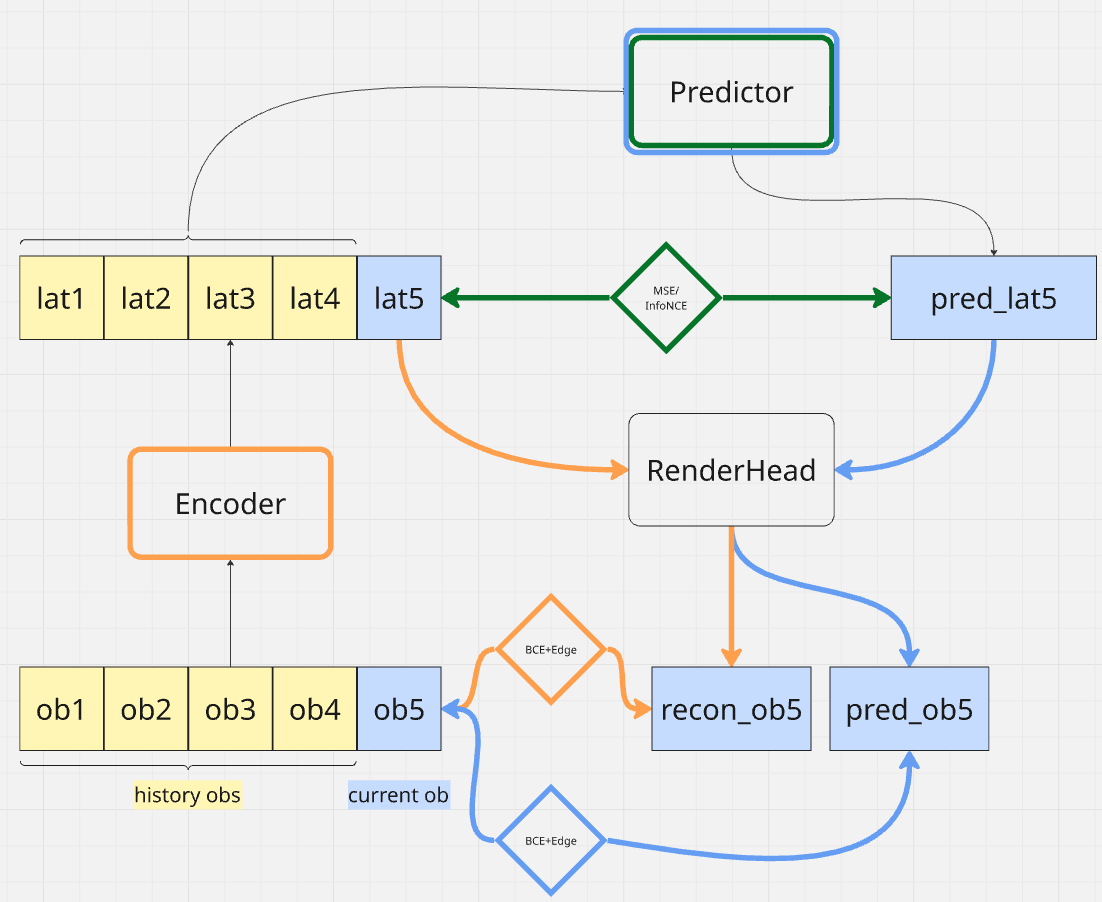
Из важного:
- для обучения энкодера оказалось достаточно последнего обза из секва. До этого прогонял все обзы, но это просто увеличивалос время тренинга, НЕ добавляя в качестве. По факту я просто брал датасет, умножал каждый элемент на 4, и прогонял этот датасет. Понятно, что на распределение это никак не влияет, а только влияет на время и потребление памяти. Короче, как только перешёл на использование только последнего обза из секва, сразу скорость в небеса.
- сравнение латентов VS сравнение через рендеринг. По скорости - небо и земля. Однозначно надо держаться за сравнение латентов, правда тут возникает вопрос - а вот где та граница, когда два латента достаточно хороши? Короче проблема граундинга, надо как-то цепочку до реальности простраивать, иначе можно (особенно при иерархической конструкции) фантазировать латентами, которые ничего общего с реальностью не имеют.
- фокусность. Возможно проблема граундинга можно решить не тем, чтобы с пиксель-перфект качеством рендерить обзы, а с тем, чтобы уметь рендерить небольшой кусочек обза. Это схоже с тем, как мы думаем о будущем. Мы не можем думать о всём сразу, мы можем думать и воображать о чём-то одном. И потом из этих частей можно сложить уже полную картинку. А вот сразу всё - это не охватывается.
- горизонт воображения. С предсказанием следующего обза есть проблема слишком короткого горизонта - порядка 0,13сек. За это время редко когда меняется позиция игрока, врагов. Чаще они просто меняет своё состояние: кралья вверх или вниз, ножки подогнуты или вытянуты. А если позиция и меняется, то незначительно. Поэтому модель может просто это обойти тем, чтобы рисовать что-то размыленное в пределах ожидамой границы перемещения. Поэтому интересно посмотреть, как будет на более длинном горизонте предсказание работать. Например, предсказывать, что будет через +1 сек.
- возникла мысль, что можно стэкировать предсказатели. И их отдельно обучать. И что каждый предсказатель потребялет латенты нижележащего.