135) больше памяти для агента
За прошедшие несколько дней окончательно перелез на 18n_ppo_tr_frostbite_07. Теперь используется TestManager вместо видео захвата. TestManager делает 32 прогона вместо одного, что даёт более стабильные результаты. Также бонусом идут margin charts: вместе со средней величиной levels_passed_mean видны минимальные и максимальные границы. Например, тут видно, что 18n_ppo_tr_frostbite_07:330 в конце аж до 8-го уровня дошёл и уверенно преодолевает 5-уровней (средняя ближе к 6-ке).
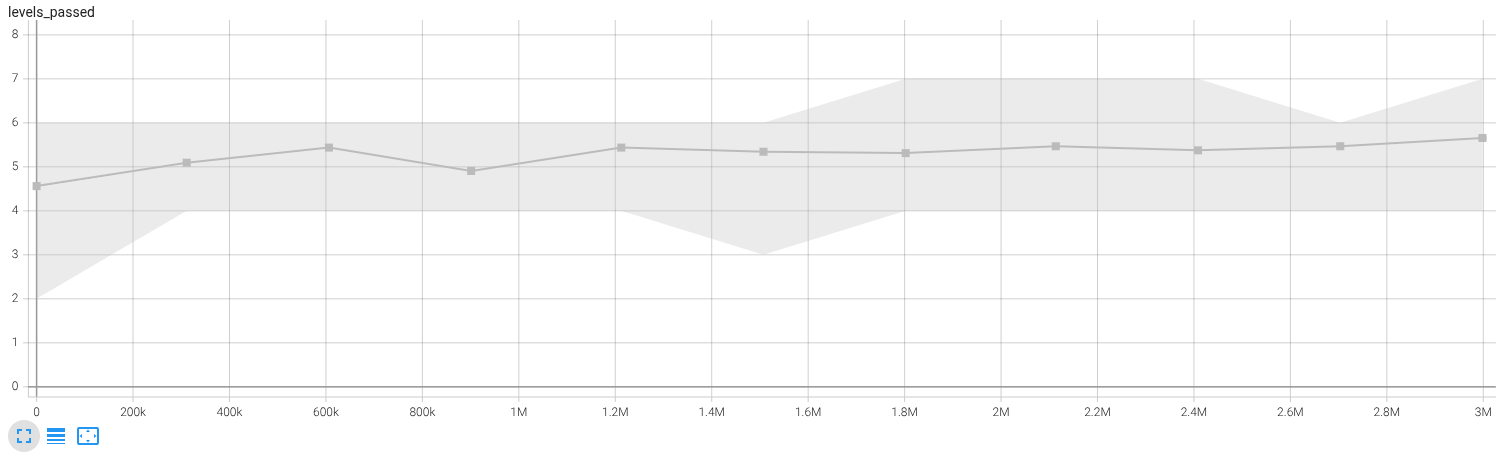
В рамках 18n_study_26.6 и 18n_study_27.6 объявился феномен “горбатости”. Сначала агент преуспевает на поздних уровнях, а потом медленно деградирует. Связываю это с разучиваением. Типа если он проводит больше времени на поздних уровнях, то начинает забывать начальные. Эффект не катастрофический, т.к. мы заставляем его постоянно проходить начальные уровни и тем самым не даём политике развалится, но всё равно неприятный.
Ещё также обнаружился феномен двух фракций: одни агенты очень стабильно проходит первые уровни практически без потерь, но не так феерично играют на поздних уровнях, а другие наоборот - играют небрежно, могут сдохнуть где-нибудь на 3 или 4-ом уровне, но зато легче доходят до 8-го.
Чем можно победить разучивание? Кажется, что только памятью. Сейчас у агента что есть: 1) коротенькая tape-like память на 4 слота - текущие наблюдения, 2) память в MLP слоях трансфомера. Видимо в таком сетапе агенту некуда просто выгрузить нерелевантную для данного уровня информацию и наоборот, подгрузить, нужную. На ум приходят архитектуры, где есть какая-нибудь матричная память, DND, LSTM или GRU. Но какой-то цельной картины, как это встроить непонятно.
Что стало более понятно, так это то, что можно пока поработать с tape-like памятью - трансформенным окном. Сейчас это 4 наблюдения. Я считал, что т.к. игра fully-observable, то этого хватает. Джемини мне подпевал только. А теперь я понимаю следующее. Да, во Frostbite нет такого понятия, как неразведанная территория или fog of war, как в StarCraft. Но это не означает, что 4-х наблюдений хватит для построения оптимальной политики. Возьмем, например, гусей. Вот они улетели с одной стороны и что-то должно появиться с другой стороны: может рыбка, может крабы, может гуси. Если у агента только 4 наблюдения, то для него просто существует миг. Появление врагов с другой стороны будет для него сюрпризом. А вот если бы у агенты была хотя бы память на несколько секунд, то он мог бы это предвидеть и действовать более оптимально. То же самое и со льдинам.
Другая аналогия. Если у агента есть только 4 наблюдения, и агент бы обитался в нашем мире, то он никогда бы не смог понять смену дня и ночи, времён года да и вообще чего-бы то ни было, что не укладывается в этот промежуток времени. Т.к. каждый эпизод для него - это всего лишь 4 наблюдения. Для него день и ночь - это как будто всегда существующее состояние. Перехода между ними просто нет. И он действует как будто всегда ночь или всегда день. И только наличие памяти позволит зацепить эти переходы и понять, что есть более низкочастотные явления, чем передвижения льдинок или гусей на пару пикселей. А раз так, то и действия его могут быть более хитрыми.
Как быстро проверить? Решил, что пока не хочется ломать архитектуру сильно и превносить какие-то другие конструкции (LSTM, GRU). Думаю просто увеличить контекстное окно до 32. Это где-то около 5 секунда времени. Но если увеличить в лоб, то сразу агент начнёт жрать кучу памяти и обучение будет длиться вечность. Поэтому идём на хитрость. Делаем окно 32, но на роллауте собираем только 4 обза. Обучаем агента, боль-мень играть. Потом морозим энкодер (а это работает - см. 18n_study_26.6), и открываем окно на полную. Т.е. в начале агент смотрит только на 4 обза (высокочастотное обучение), а потом получает доступ к более богатой истории. И по идее он должен стать более умным.