136) Больше памяти в лоб не работает
С 1 октября я поставил на память. Гипотеза из #135: агенту не хватает не наблюдений, а времени. Окну на 4 кадра нечем связать гусей, льдины и смену уровня в один поток — для него это набор несвязанных мгновений. Идея была простая: расширить окно до 32, но не в лоб, а с хитростью — сначала учить на четырёх кадрах, потом морозить энкодер и открывать историю.
Первые 11 дней показали, что хитрость нужна не зря. Но и её мало.
> между делом: те же 11 дней агент-ассистент получил больше памяти и разобрался с долговременным хранением. Забавно ставить задачи памяти модели мира ровно тогда, когда чинишь память у собственного цифрового коллеги.
Что сделали с окном
Собрал 18n_ppo_tr_frostbite_08: длина истории теперь задаётся через sequence_ages, а временная разметка — синусоидальная, как в ванильном трансформере (Васвани и соавт., «Attention Is All You Need»). Уже это ставило вопрос: то же это самое «окно пошире» или другое качество.
Первый прогон — 18n_study_36.1 — был ещё на старой схеме. Новую temporal_encoding там не реализовали: работали старые learned-параметры, sequence_ages не использовался. То есть все 16 обзов каждый раз грузились агенту на ленту целиком. Честное «окно 16 против 4», без хитростей.
Результат неутешительный. Окно 16 значимо хуже: средняя 0.5561 против 0.6272 у бейзлайна с окном 4 (18n_study_31.1). Лучший агент с окном 16 (25) — 0.7594, лучший бейзлайн (521, 528) — 0.7969.
Вывод: окно само по себе не лекарство. И дело, скорее всего, не в самой памяти как таковой, а во времени — чтобы научиться пользоваться более длинной историей, агенту, видимо, нужно заметно больше обучения. Пока окно 16 — это не «умнее», а «дороже».
Модель мира: проблема была в данных
Долго бились с системной проблемой recon/0.1+recon/3.0 — модель неверно восстанавливала нижний ряд льдин.
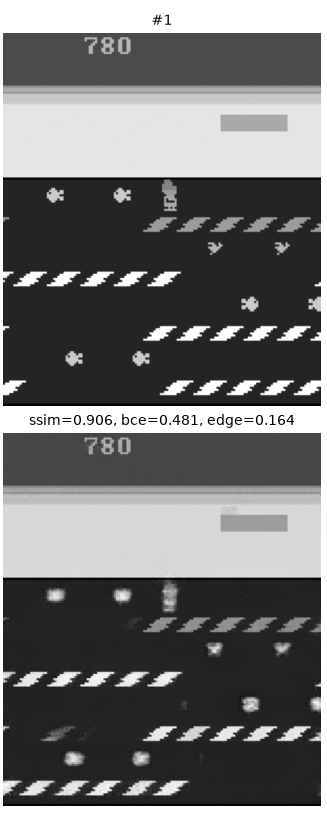
Пробовали ёмкость VisionHead (24.1, 25.1), ёмкость и число слоёв RenderHead (26.1, 27.1), ширину d_model (28.1). Всё давало копейки и проблему не решало.
Разгадка пришла в 18d_study_30.1: дело было не в модели, а в данных. Объединили текущие 16 датасетов с 12 из 18d_world_model_09:40 — итого 28 — и получили ssim 0.9905. Месяцы тюнинга архитектуры против правильно собранного датасета: датасет выиграл.
Дотренировали чемпионов (18d_study_30.2) — взяли VisionHead версии 183 (ssim 0.9936). На нём теперь строится вся 18n-линейка.
Потолок третьего уровня
Дальше — самое неприятное. На 183 собрали новый бейзлайн (18n_study_31.1), но чемпионы 18n_study_32 оказались сплошной посредственностью: все упёрлись в levels_passed=3. В сентябре мы брали 5 уровней (см. #133). Новый бейзлайн не дотягивает до старого — это и есть «хтонь» 34-й линейки, которую 34.3b–34.5 пытались продавить количеством прогонов. Не продавили.
Сквозной прогон 18n_study_35 вернул логику работы от обзов на оптимизации, как в старом frostbite_07_old. Дались жидкие прострелы (18n_study_35.4 — 3.75), но не прорыв. Финальная попытка 18n_study_35.3d — тот же третий шаг, но на старом коде — 3.0.
Вывод трезвый, без посыпания головы пеплом: низковисячие фрукты съедены. Простые рычаги — количество прогонов, анниллинг, логика обзов — дали своё, и дальше ими не выехать. Остаётся либо случайность, либо сам VisionHead. Значит, пора изобретать новые подходы, а не перебирать старое.
Где угнетается исследование (спойлер: не сильно)
Отдельная ветка — расследование 18n_study_23.3b–23.3n вокруг AMP. Тут пришлось городить новый гипер is_obs_usage_enforced, чтобы воспроизвести логику старого 18n_ppo_tr_frostbite_07: на роллауте без AMP, на оптимизации — с AMP, но с полной цепочкой obs → VisionHead → Encoder → ob_latents.
is_obs_usage_enforced оказался очень коварным. Из-за него можно было неявно менять VisionHead, даже когда его обучение выключено. Дело в используемых внутри него BatchNorm2d. По-дефолту модель стоит в train режиме, и поэтому при прогоне батчей на оптимизации у неё меняются running_mean, running_var. А в прологе к оптимизации стояла строка:
if RT.vision_head.is_trainable: RT.vision_head.train()
Т.е. получается, что без явного вызова RT.vision_head.eval() на оптимизации мы начинали менять VisionHead неявным образом!
Правильный код:
RT.vision_head.train(RT.vision_head.is_trainable)
По-честному, выхлоп небольшой. И с prediction_loss не сказать, что эффект прямо такой уж сильный: убрали — хуже, вернули — лучше, но всё на грани шума. Скорее всего, дело опять-таки в самом VisionHead и в случайности.
Разное
Победили недетерминизм PPO: torch.use_deterministic_algorithms(True) + cudnn.deterministic=True + cudnn.benchmark=False, плюс дефолты по дропауту и шуму. Теперь запуски с одним random_seed сходятся до копейки — с этим проще сравнивать эксперименты.
Что дальше
- Сфокусироваться на 8-обзовом варианте, где работают два timescale. Понять, помогает ли такая схема растить выдающихся чемпионов.
- Если не поможет — возвращаться к
VisionHeadверсии40и заниматься регрессионной охотой. prediction_lossоставить как есть: убедительных доказательств, что он что-то сильно портит, нет.